Качество данных
| Этот модуль представляет собой введение в вопросы качества данных. |
Качество данных
|
В этом видео (12:26) вы познакомитесь с терминологией, используемой в данном курсе. Если у вас не получается посмотреть встроенное видео, вы можете скачать его на свой компьютер по ссылке: download. (MP4 — 56,4 МБ) |
Текст презентации
Нажмите, чтобы раскрыть
Слайд 1 — Основы — Качество данных
Два основных понятия, которые мы рассмотрим, — это пригодность для использования и показатели качества. Они станут основой для дальнейшего изучения более детальных концепций и методов обеспечения качества данных.
Фото: GBIF: https://www.gbif.org/occurrence/2550045989 Ictinaetus malayesnsis (Temminck, 1822) Правообладатель: cupag_kelley Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка: https://www.inatu…g/photos/58972976
Слайд 2 — Основные понятия качества данных
Два основных понятия, которые мы рассмотрим, — это пригодность для использования и показатели качества. Они станут основой для дальнейшего изучения более детальных концепций и методов обеспечения качества данных.
Фото: GBIF: https://www.gbif.org/occurrence/2550045989 Ictinaetus malayesnsis (Temminck, 1822) Правообладатель: cupag_kelley Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка: https://www.inatu…g/photos/58972976
Слайд 3 — Качество данных
Прежде чем мы начнём, я хотел бы немного пояснить, почему качество данных так важно. «Чистота — залог праведности» (Cleanliness is next to Godliness) — выражение, которое мы иногда используем, говоря о важности качества данных. В данном случае под праведностью можно понимать святость, а то, что считается святым, многие воспринимают как заслуживающее доверия. Поэтому применительно к качеству данных мы с большей вероятностью будем доверять и использовать данные, которые были очищены и за которыми осуществлялся надлежащий уход.
Фото: GBIF: https://www.gbif.org/occurrence/2611012759 Rhododendron kasangiae D.G. Long & Rushforth Правообладатель: Сангай Вангчук (Sangay Wangchuk) Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка: https://www.inatu…g/photos/68350578
Слайд 4 — Качество данных
Возвращаясь к области информатики биоразнообразия, классическое определение качества данных было сформулировано Артуром Чапманом (Arthur Chapman) в 2005 году. Он писал: «Качество данных связано с их использованием и не может оцениваться независимо от пользователя. В базе данных сами по себе данные не обладают фактическим качеством или ценностью (Dalcin 2004); они имеют лишь потенциальную ценность, которая реализуется, когда кто-либо использует эти данные для решения полезной задачи. Качество информации связано с её способностью удовлетворять потребности пользователей и соответствовать их требованиям (English 1999)». Артур Чапман (Arthur Chapman) Таким образом, наша задача как специалистов, отвечающих за поддержание данных, — сделать публикуемые данные максимально полезными для всех потенциальных пользователей. Для этого мы стремимся обеспечивать максимально высокое качество данных.
Фото: GBIF: https://www.gbif.org/occurrence/2634451942 Dendrochirus zebra (Cuvier, 1829) Правообладатель: Райан Юэ Ва Чан (Yue Wah Chan) Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка: https://www.inatu…g/photos/76358738
Слайд 5 — Качество данных
Чтобы помочь вам в решении этой задачи, мы рассмотрим понятие пригодности данных для использования. Мы также познакомимся с показателями качества, в частности с корректностью и согласованностью. Это важные понятия, которые необходимо понимать и уметь применять при описании собственных данных или данных, за поддержание которых вы отвечаете.
Фото: GBIF: https://www.gbif.org/occurrence/2238803261 Papilio paris Linnaeus, 1758 Правообладатель: CheongWeei Gan Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка: https://www.inatu…g/photos/35832506
Слайд 6 — Пригодность для использования в реальных условиях
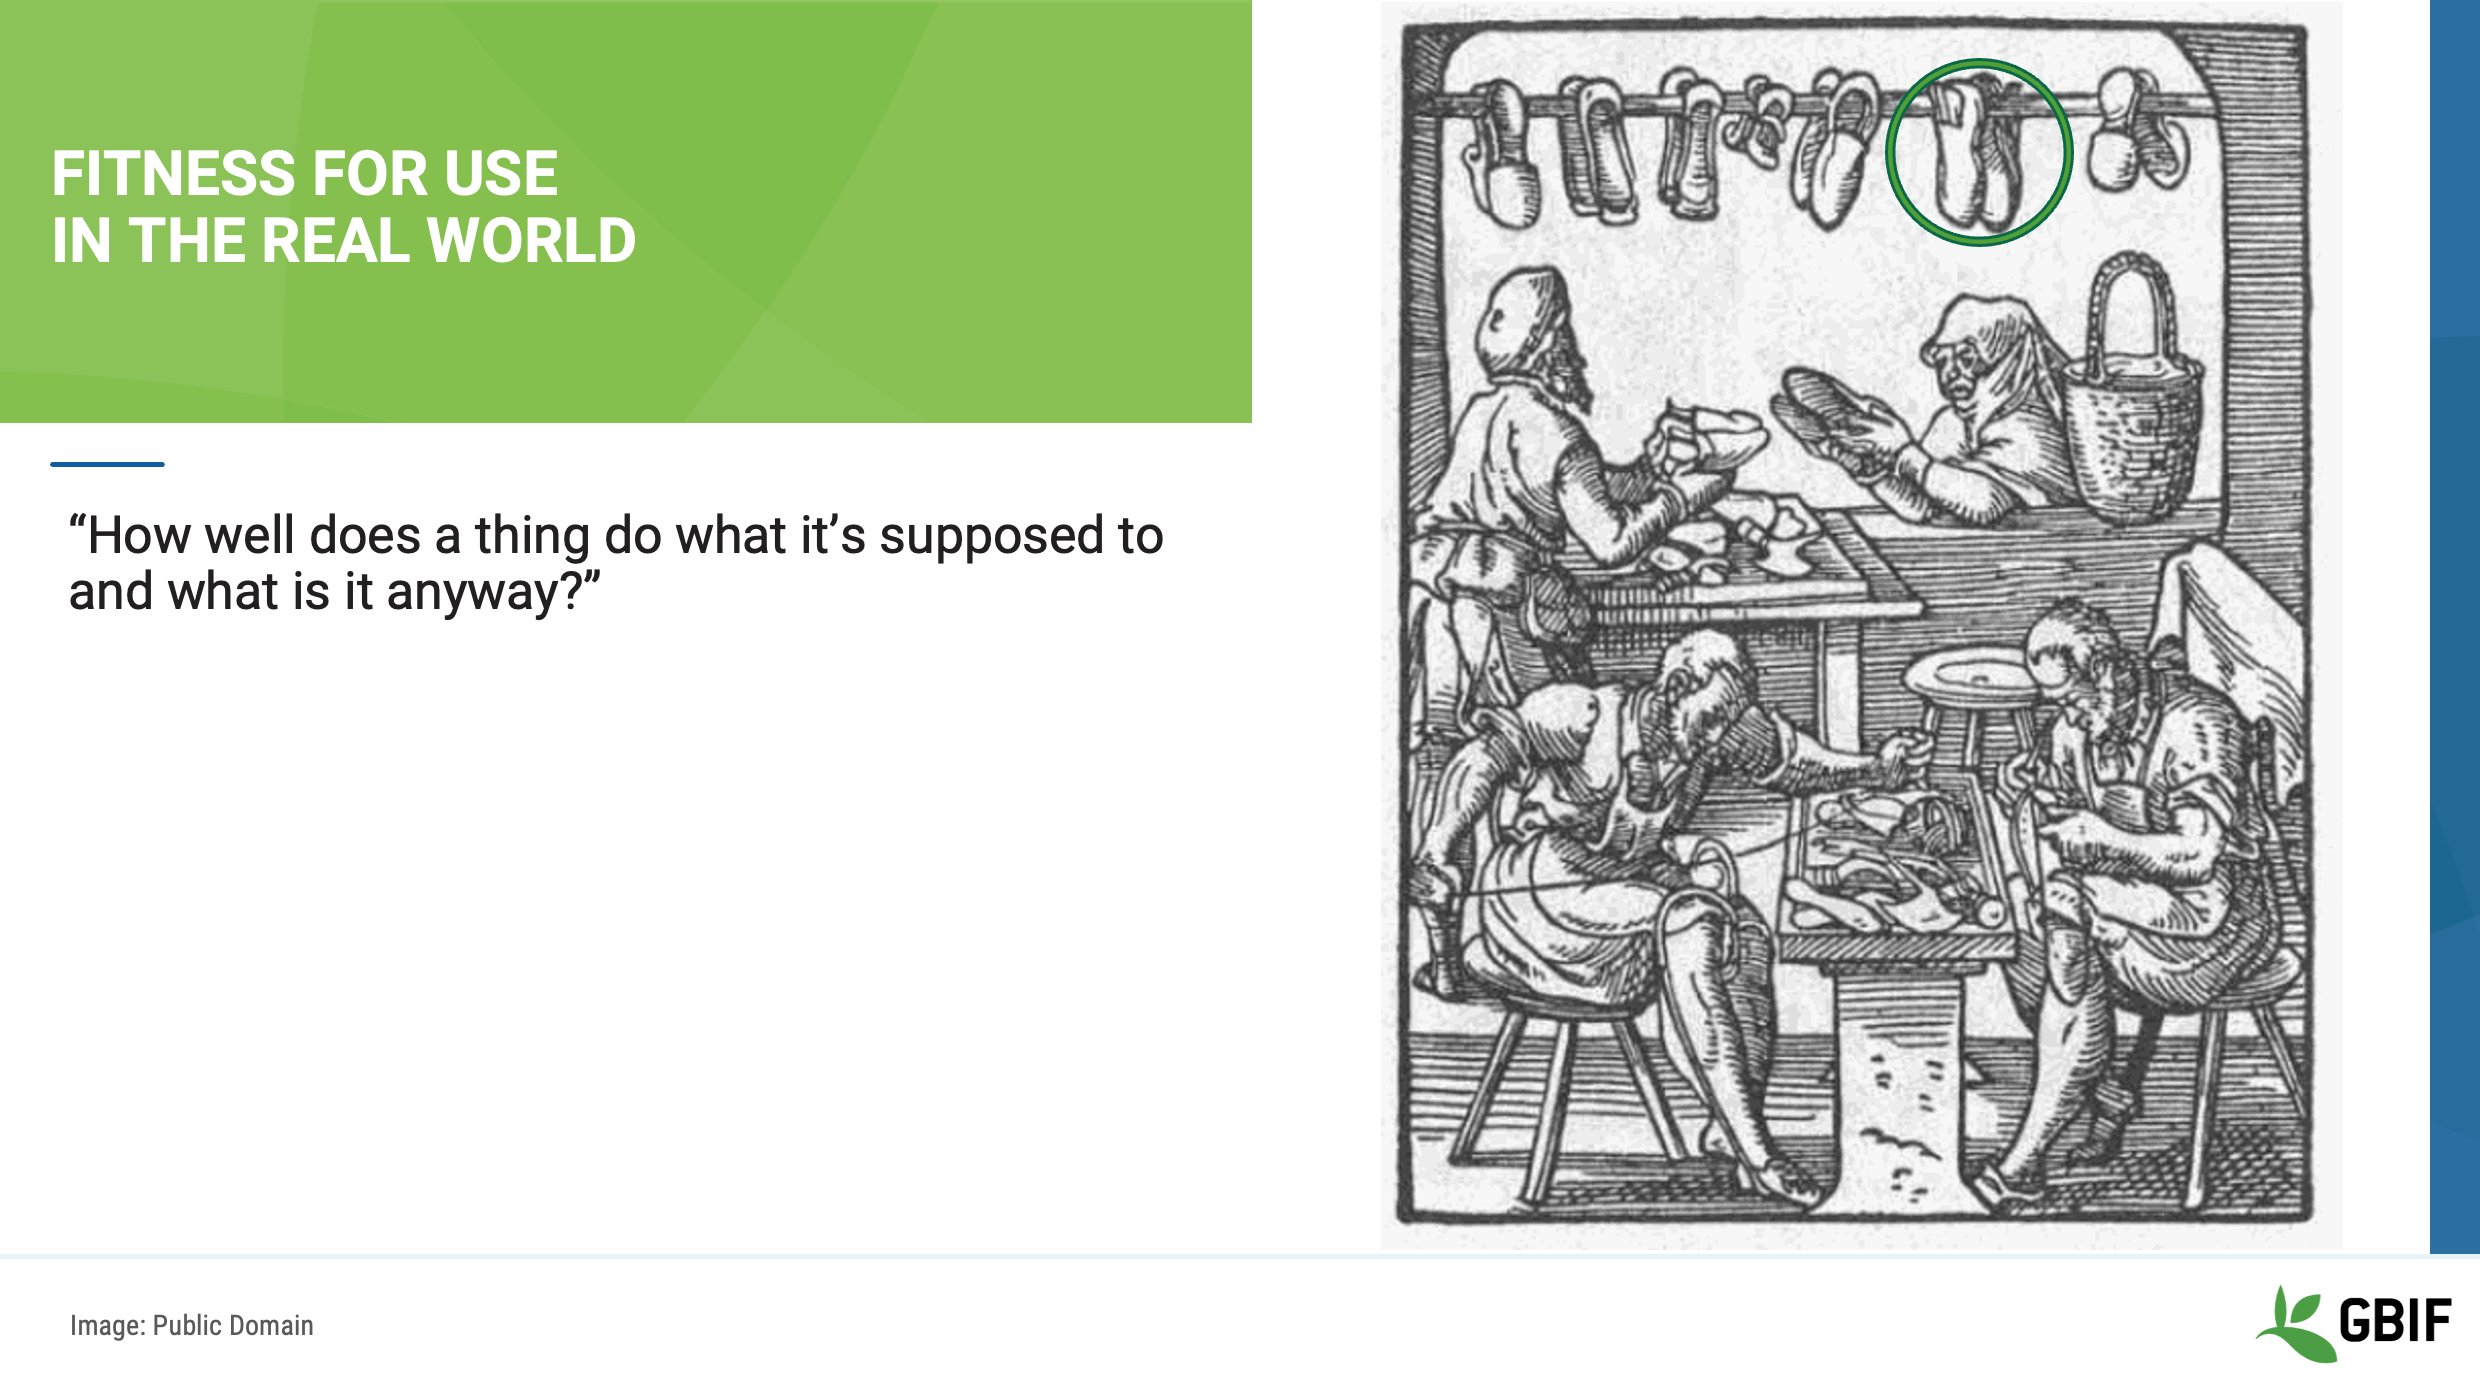
Начнём с примера, иллюстрирующего понятие пригодности для использования. Сапожник изготавливает пару деревянных башмаков, предназначенных для защиты ног человека, подобных тем, что показаны в верхней части изображения.
Источник изображения: https://commons.wikimedia.org/wiki/File:Schuhmacher-1568.png

Слайд 7 — Пригодность для использования в реальных условиях
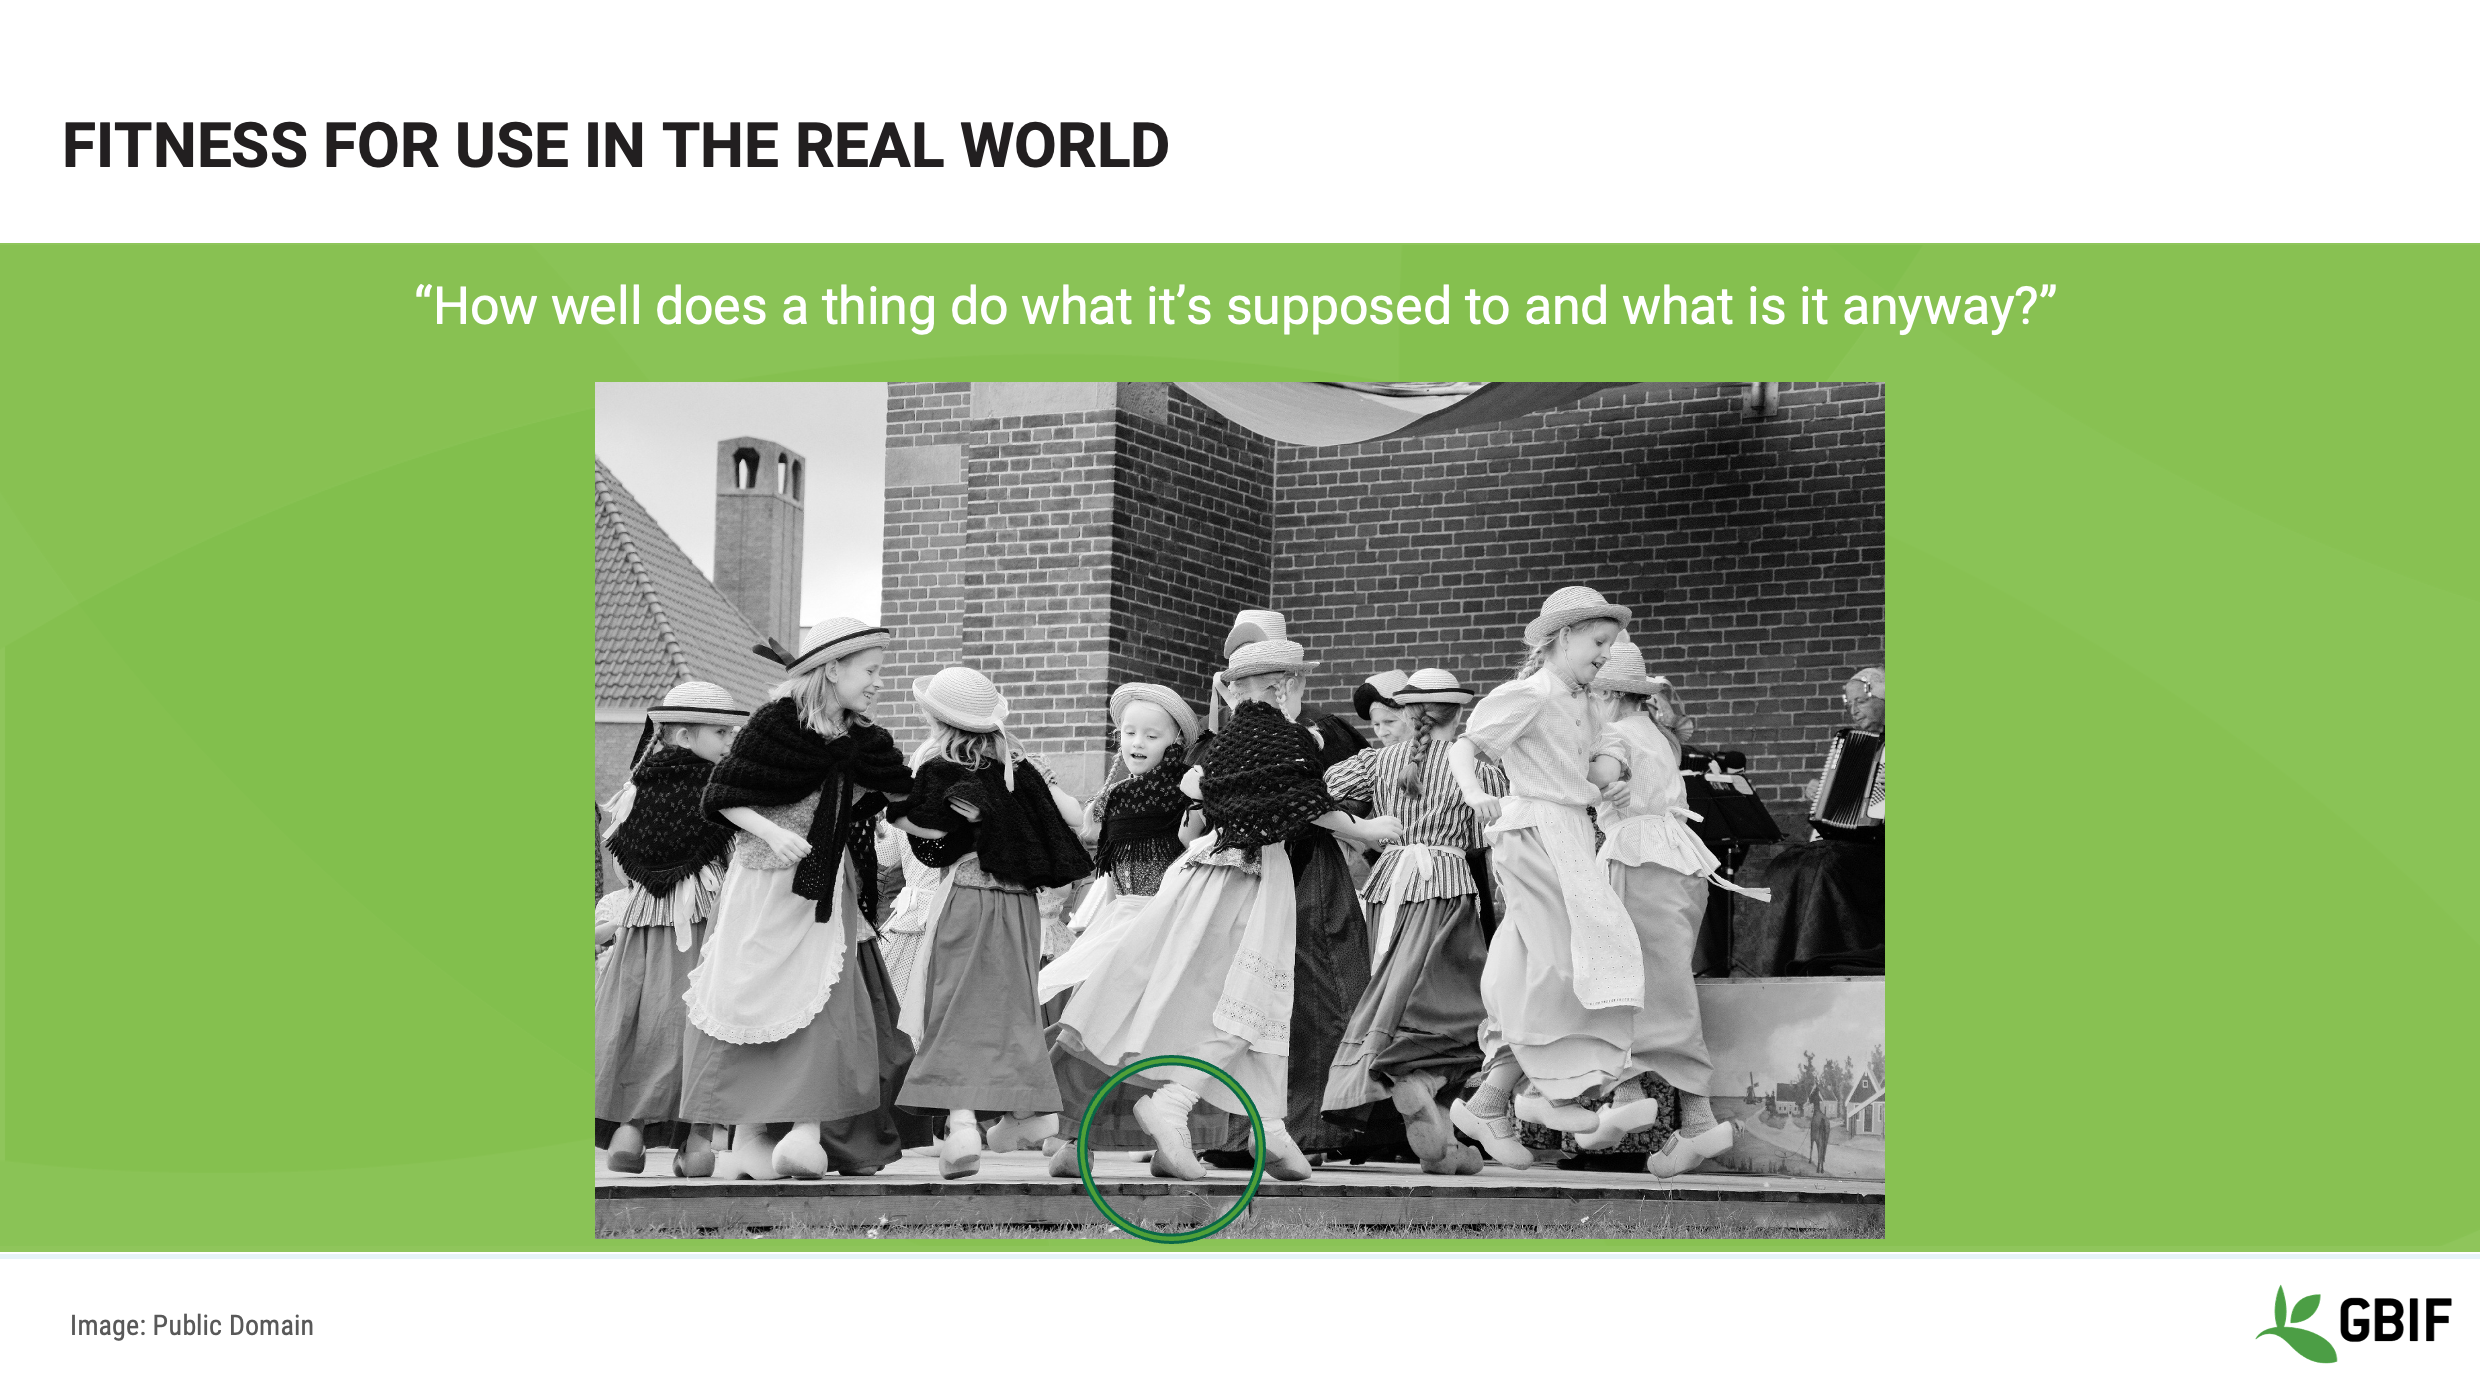
Знал ли сапожник, когда изготавливал эти башмаки, что эта девочка будет танцевать в них? Возможно.
Источник изображения: https://www.publicdomainpictures.net/en/view-image.php?image=157723&picture=&jazyk=CN
Слайд 8 — Пригодность к использованию в реальных условиях
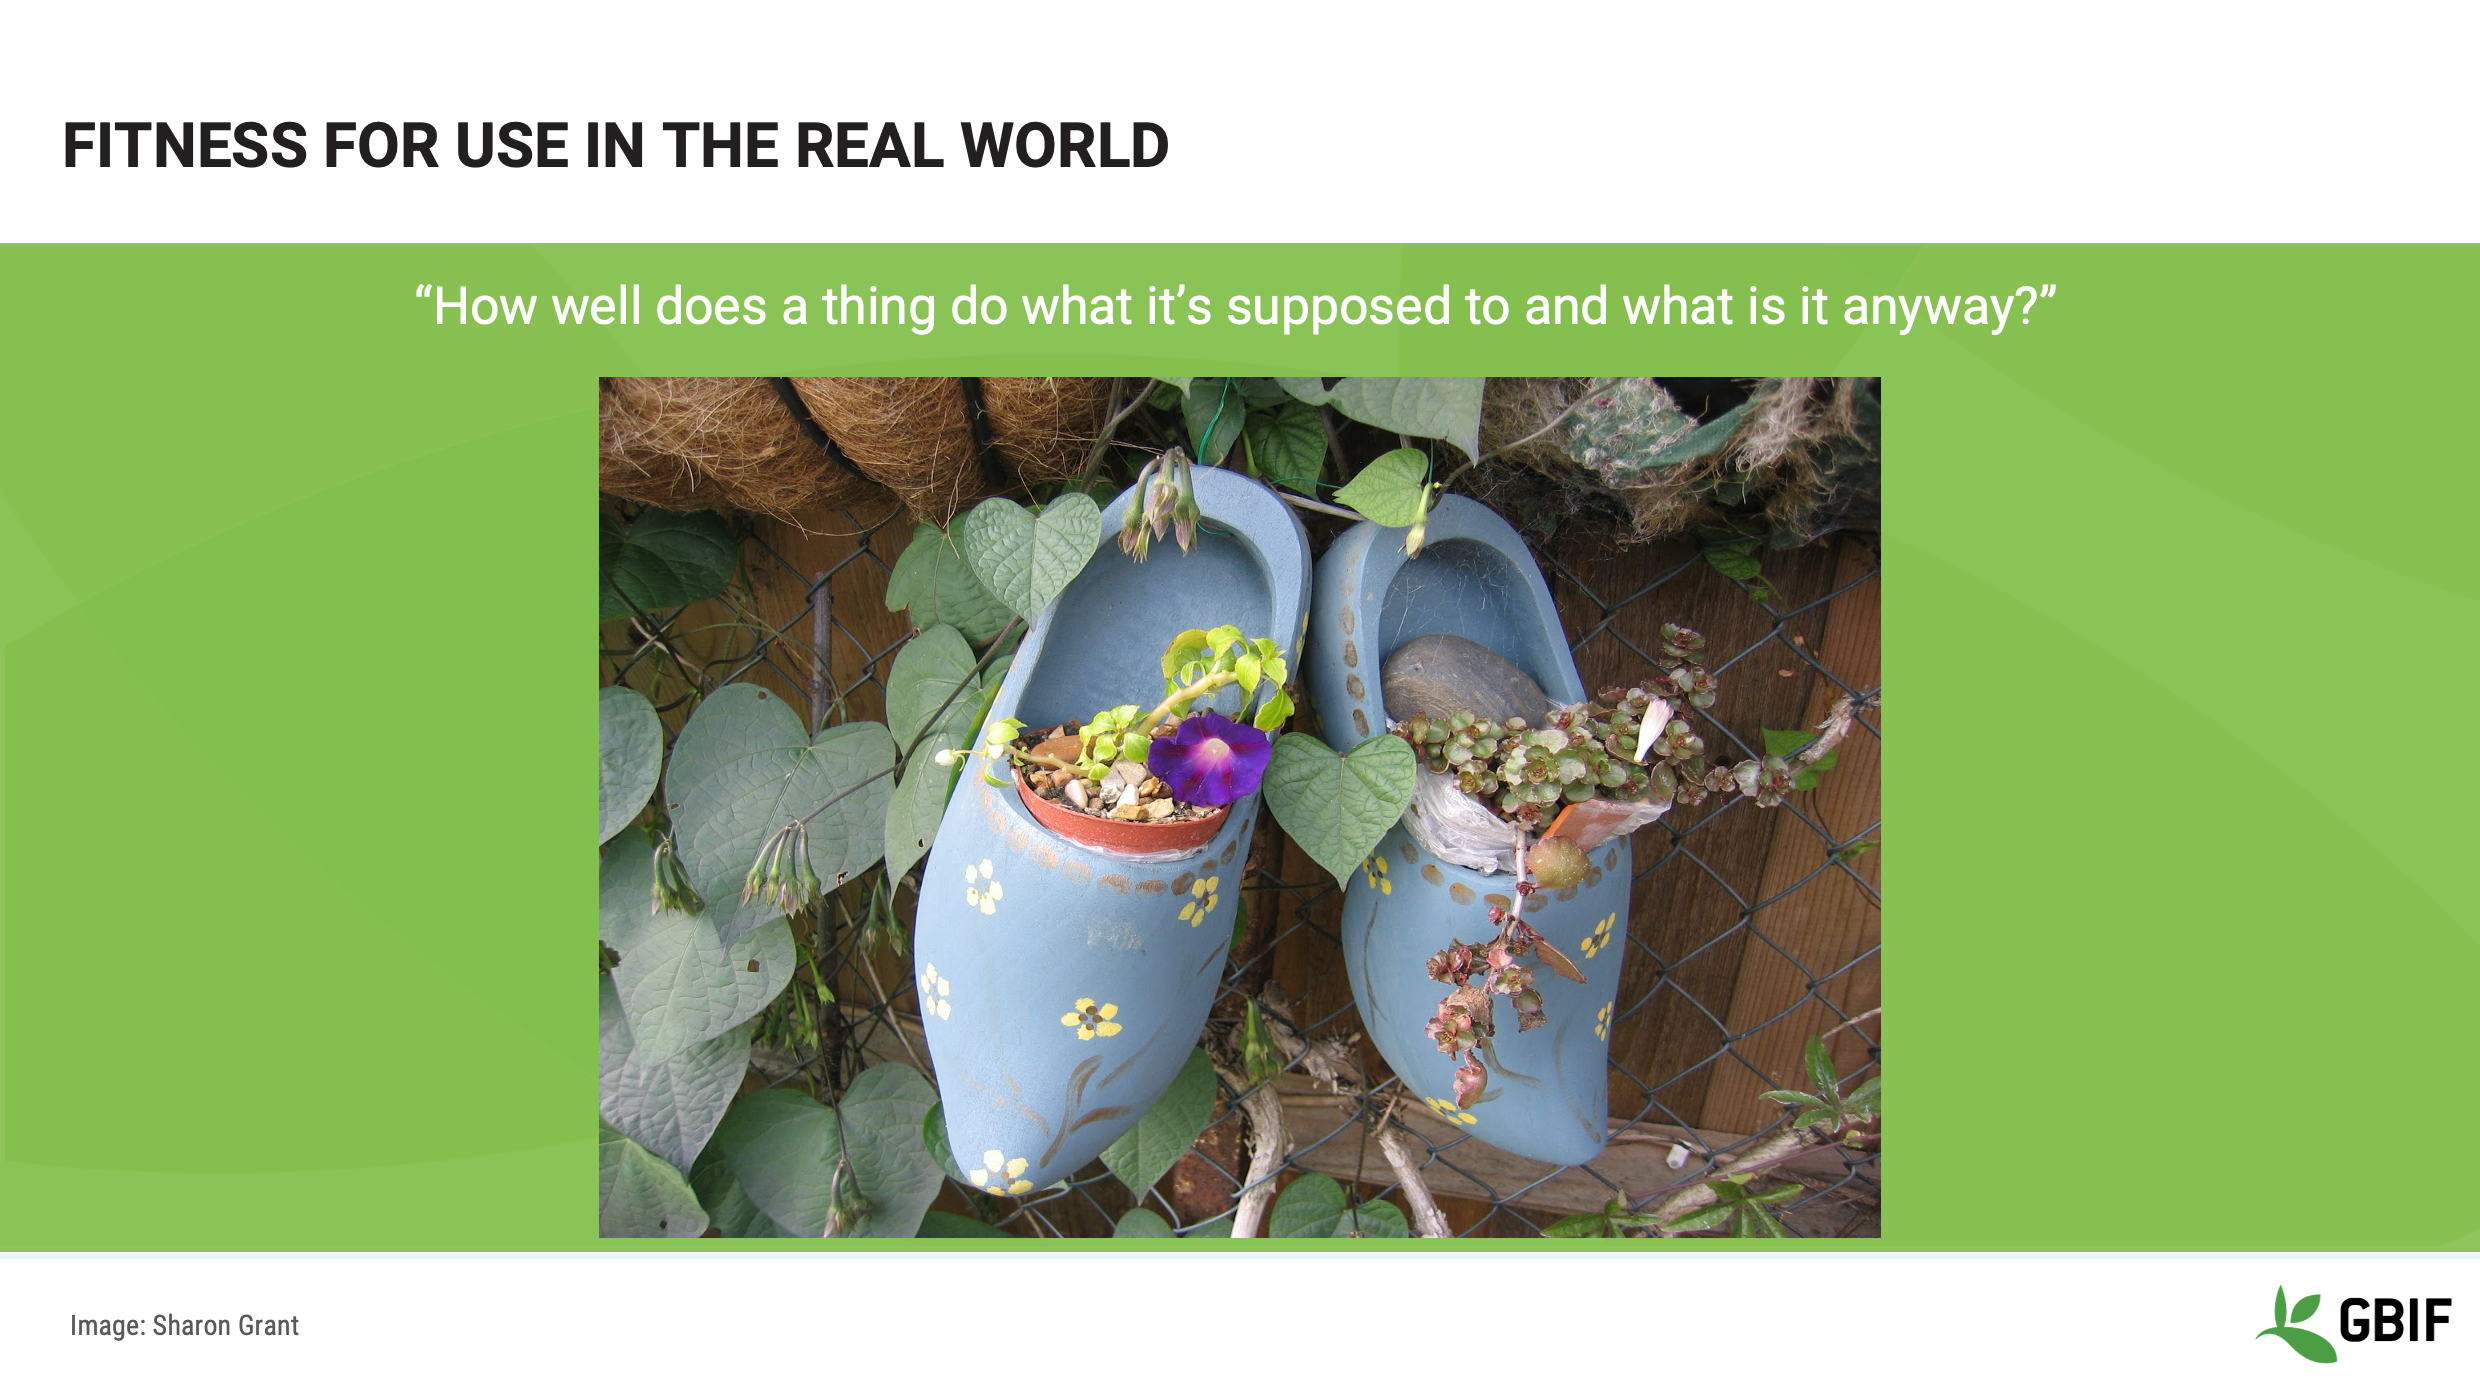
Как вы думаете, мог ли тот же сапожник предполагать, что однажды садовник использует эти башмаки в качестве цветочных горшков? Скорее всего, нет. Источник изображения: Шэрон Грант (Sharon Grant) [https://www.flickr.com/photos/rondls_pics/4941594970/in/album-72157616943444786/]
Слайд 9 — Пригодность к использованию
В экологических науках часто говорят о пригодности данных для использования, однако важно помнить, что данные сами по себе не являются хорошими или плохими. Их ценность определяется тем, как и для каких целей они используются. Например, одному исследователю данных, определённых до уровня рода, может быть достаточно для построения прогностических моделей экологических ниш. В то же время для исследователя, изучающего конкретный таксон, те же данные на уровне рода будут значительно менее полезны, чем более детальные данные о находках организмов, включающие информацию о подвидах.
Фото: GBIF: https://www.gbif.org/occurrence/1621797237 Calotes mystaceus Duméril & Bibron, 1837 Правообладатель: robbythai Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка: https://www.inatu…rg/photos/9949104
Слайд 10 — Пригодность к использованию
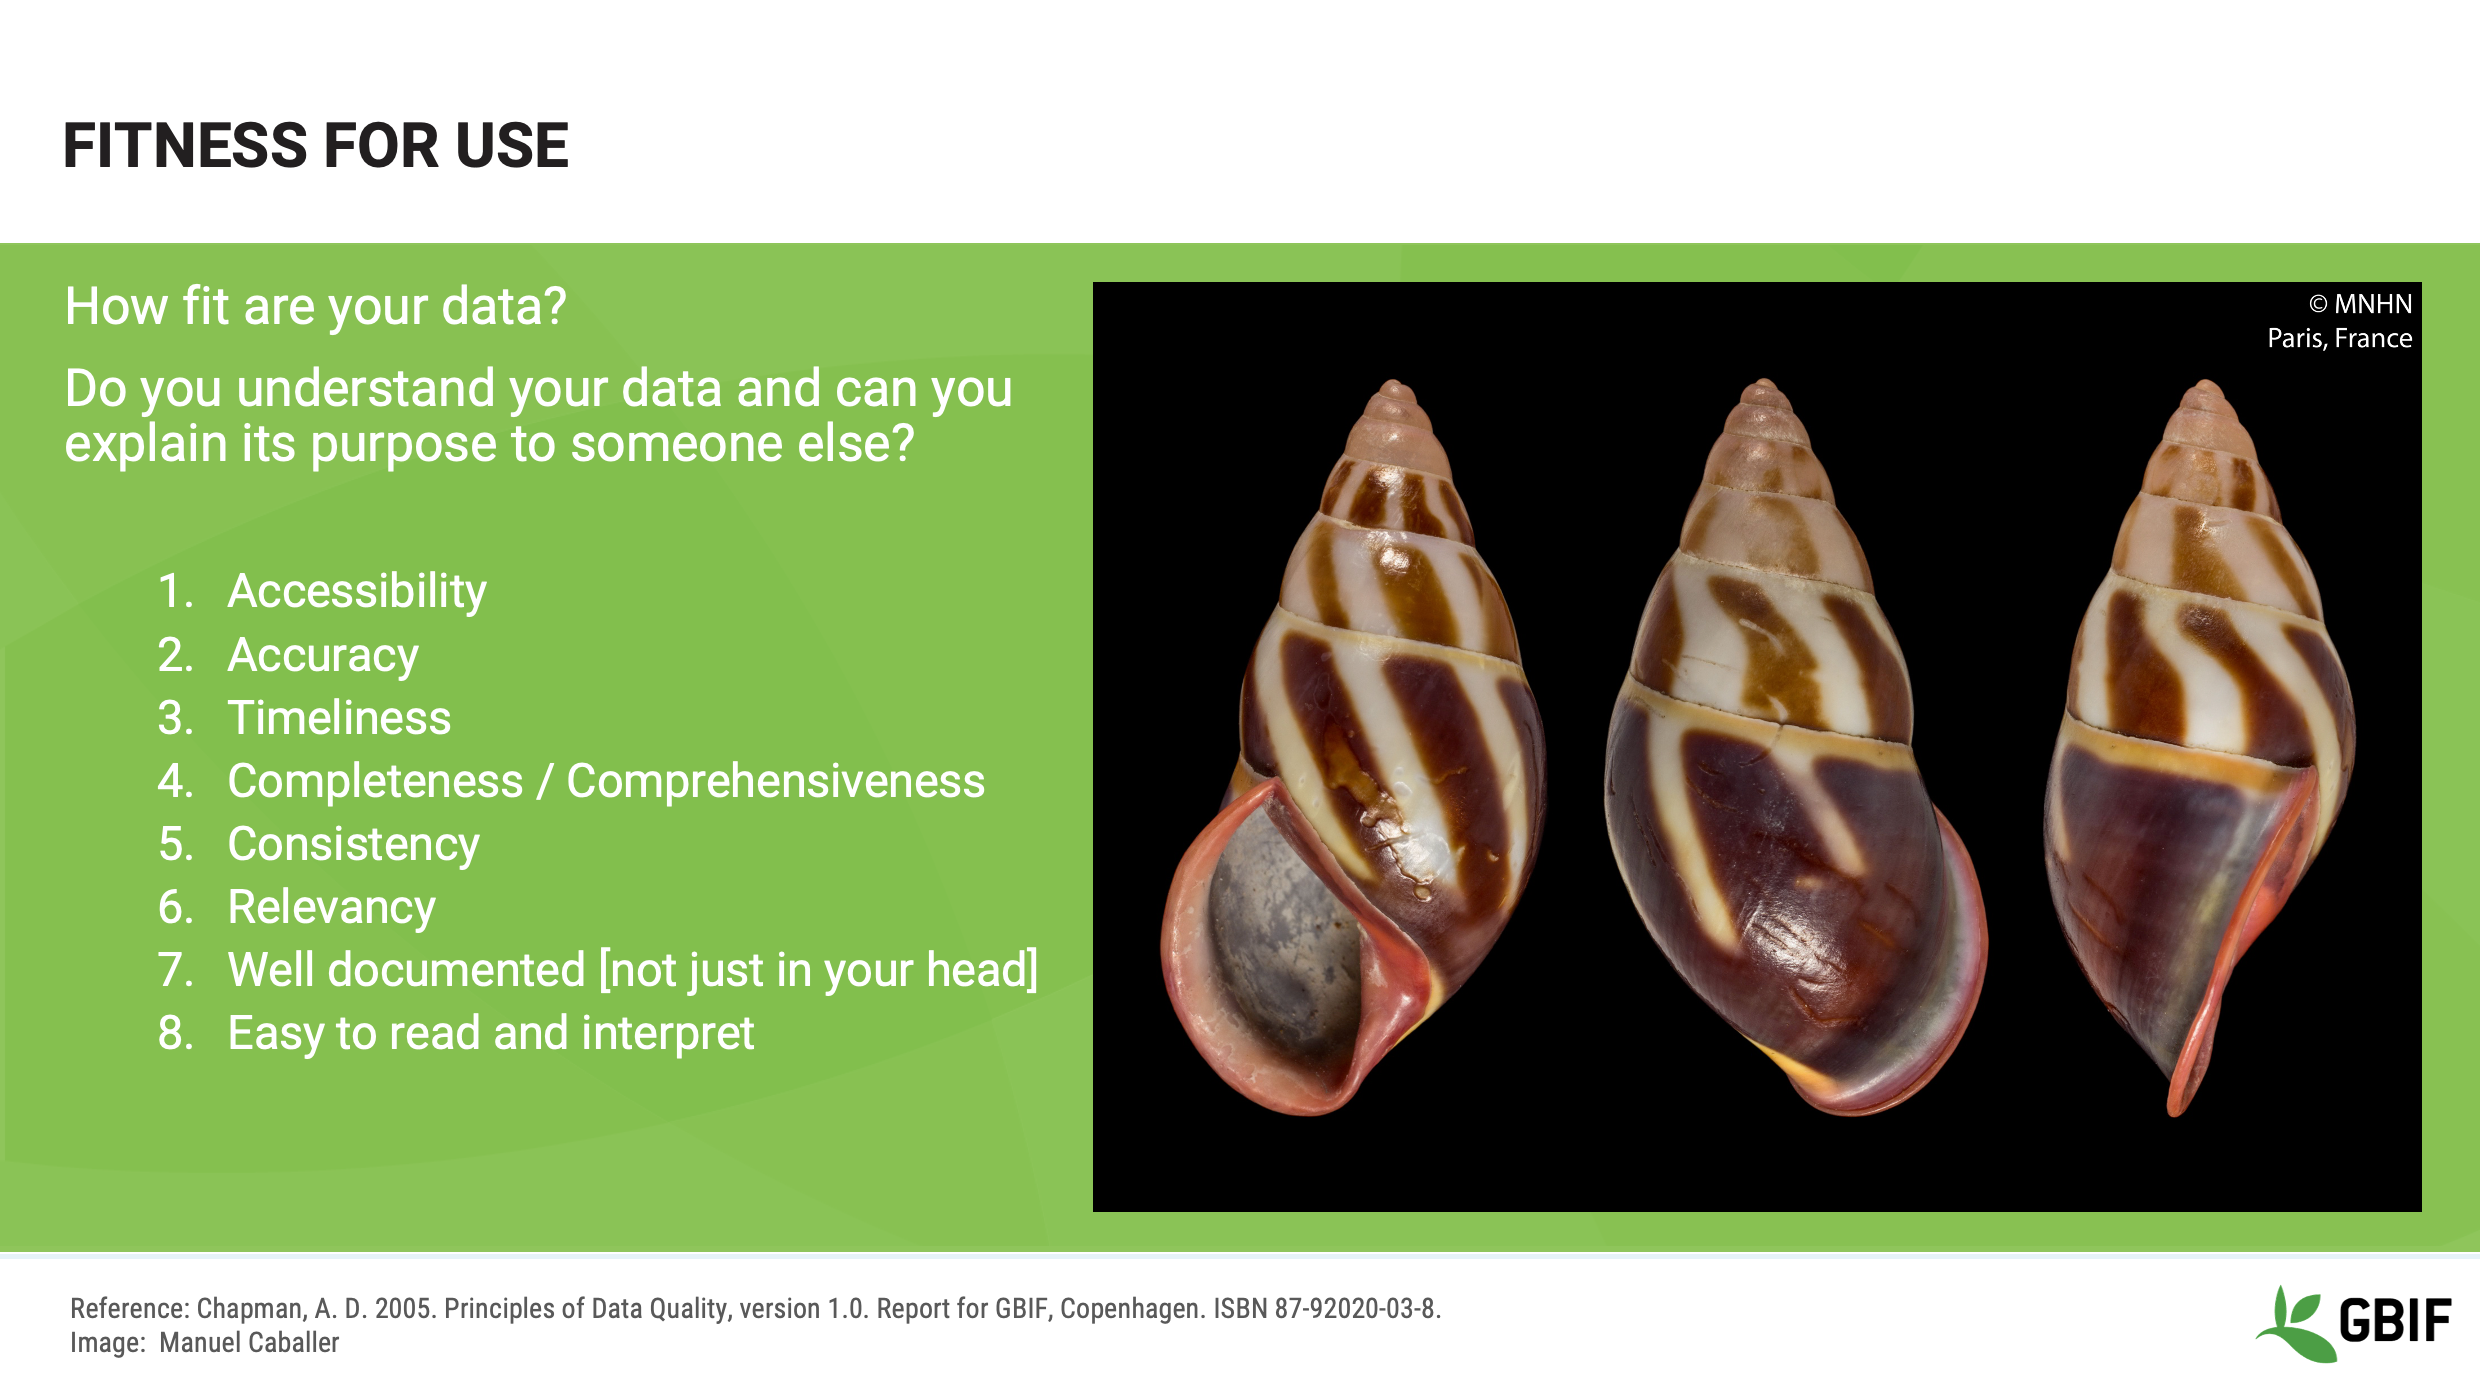
Итак, что такое пригодность для использования и как это понятие связано с данными? Говоря о пригодности для использования, Чапман отмечает, что после создания и публикации набора данных существуют две основные точки зрения на возможное использование этих данных: точка зрения создателя данных и точка зрения пользователя. Чтобы помочь потенциальному пользователю определить, насколько ваши данные заслуживают доверия и подходят для его целей, необходимо хорошо понимать собственные данные и уметь предоставлять информацию о них. Ниже приведены некоторые важные вопросы о метаданных, то есть характеристиках ваших данных, на которые вы должны уметь ответить и предоставить эту информацию другим: . Насколько доступны ваши данные? Насколько легко кто-либо может получить к ним доступ? Люди не смогут использовать данные, если не смогут их найти. . Насколько точны ваши данные? Можно ли им доверять? Например, актуальны ли определения видов и были ли они выполнены известными специалистами? . Насколько своевременны ваши данные? Когда данные будут доступны? Как часто они обновляются? . Насколько полны и всесторонни ваши данные? Какие части набора данных документированы полностью? Насколько хорошо данные охватывают определённый период времени, территорию или предметную область? . Насколько они согласованы? Всегда ли данные в каждом поле представлены в одном и том же формате? Были ли данные собраны с использованием одних и тех же документированных протоколов? . Насколько релевантны ваши данные? Насколько этот набор данных схож с другими наборами, которые уже успешно использовались для той же цели? . Насколько детальны ваши данные? Какова степень детализации данных? В каком масштабе их можно использовать для картографирования? . Насколько легко интерпретировать ваши данные? Чётко и понятно ли документирован набор данных? Если документы написаны от руки, легко ли разобрать почерк?
Фото: GBIF: https://www.gbif.org/occurrence/1932569869 Amphidromus goldbergi Thach & F. Huber, 2018 Правообладатель: Manual Caballer Лицензия: http://creativeco…/licenses/by/4.0/ Идентификатор: https://mediaphoto.mnhn.fr/media/1546617441086USKcRv3tfQkB8mZo
Слайд 11 — Показатели качества
В то время как пригодность для использования носит субъективный характер, показатели качества данных гораздо более объективны. Чапман отмечает, что:
«Любые данные содержат ошибки — избежать этого невозможно! Важно знать, в чём заключаются эти ошибки, и понимать, находятся ли они в допустимых пределах с учётом целей, для которых предполагается использовать данные. (Chapman 2005)»
Слайд 12 — Показатели качества
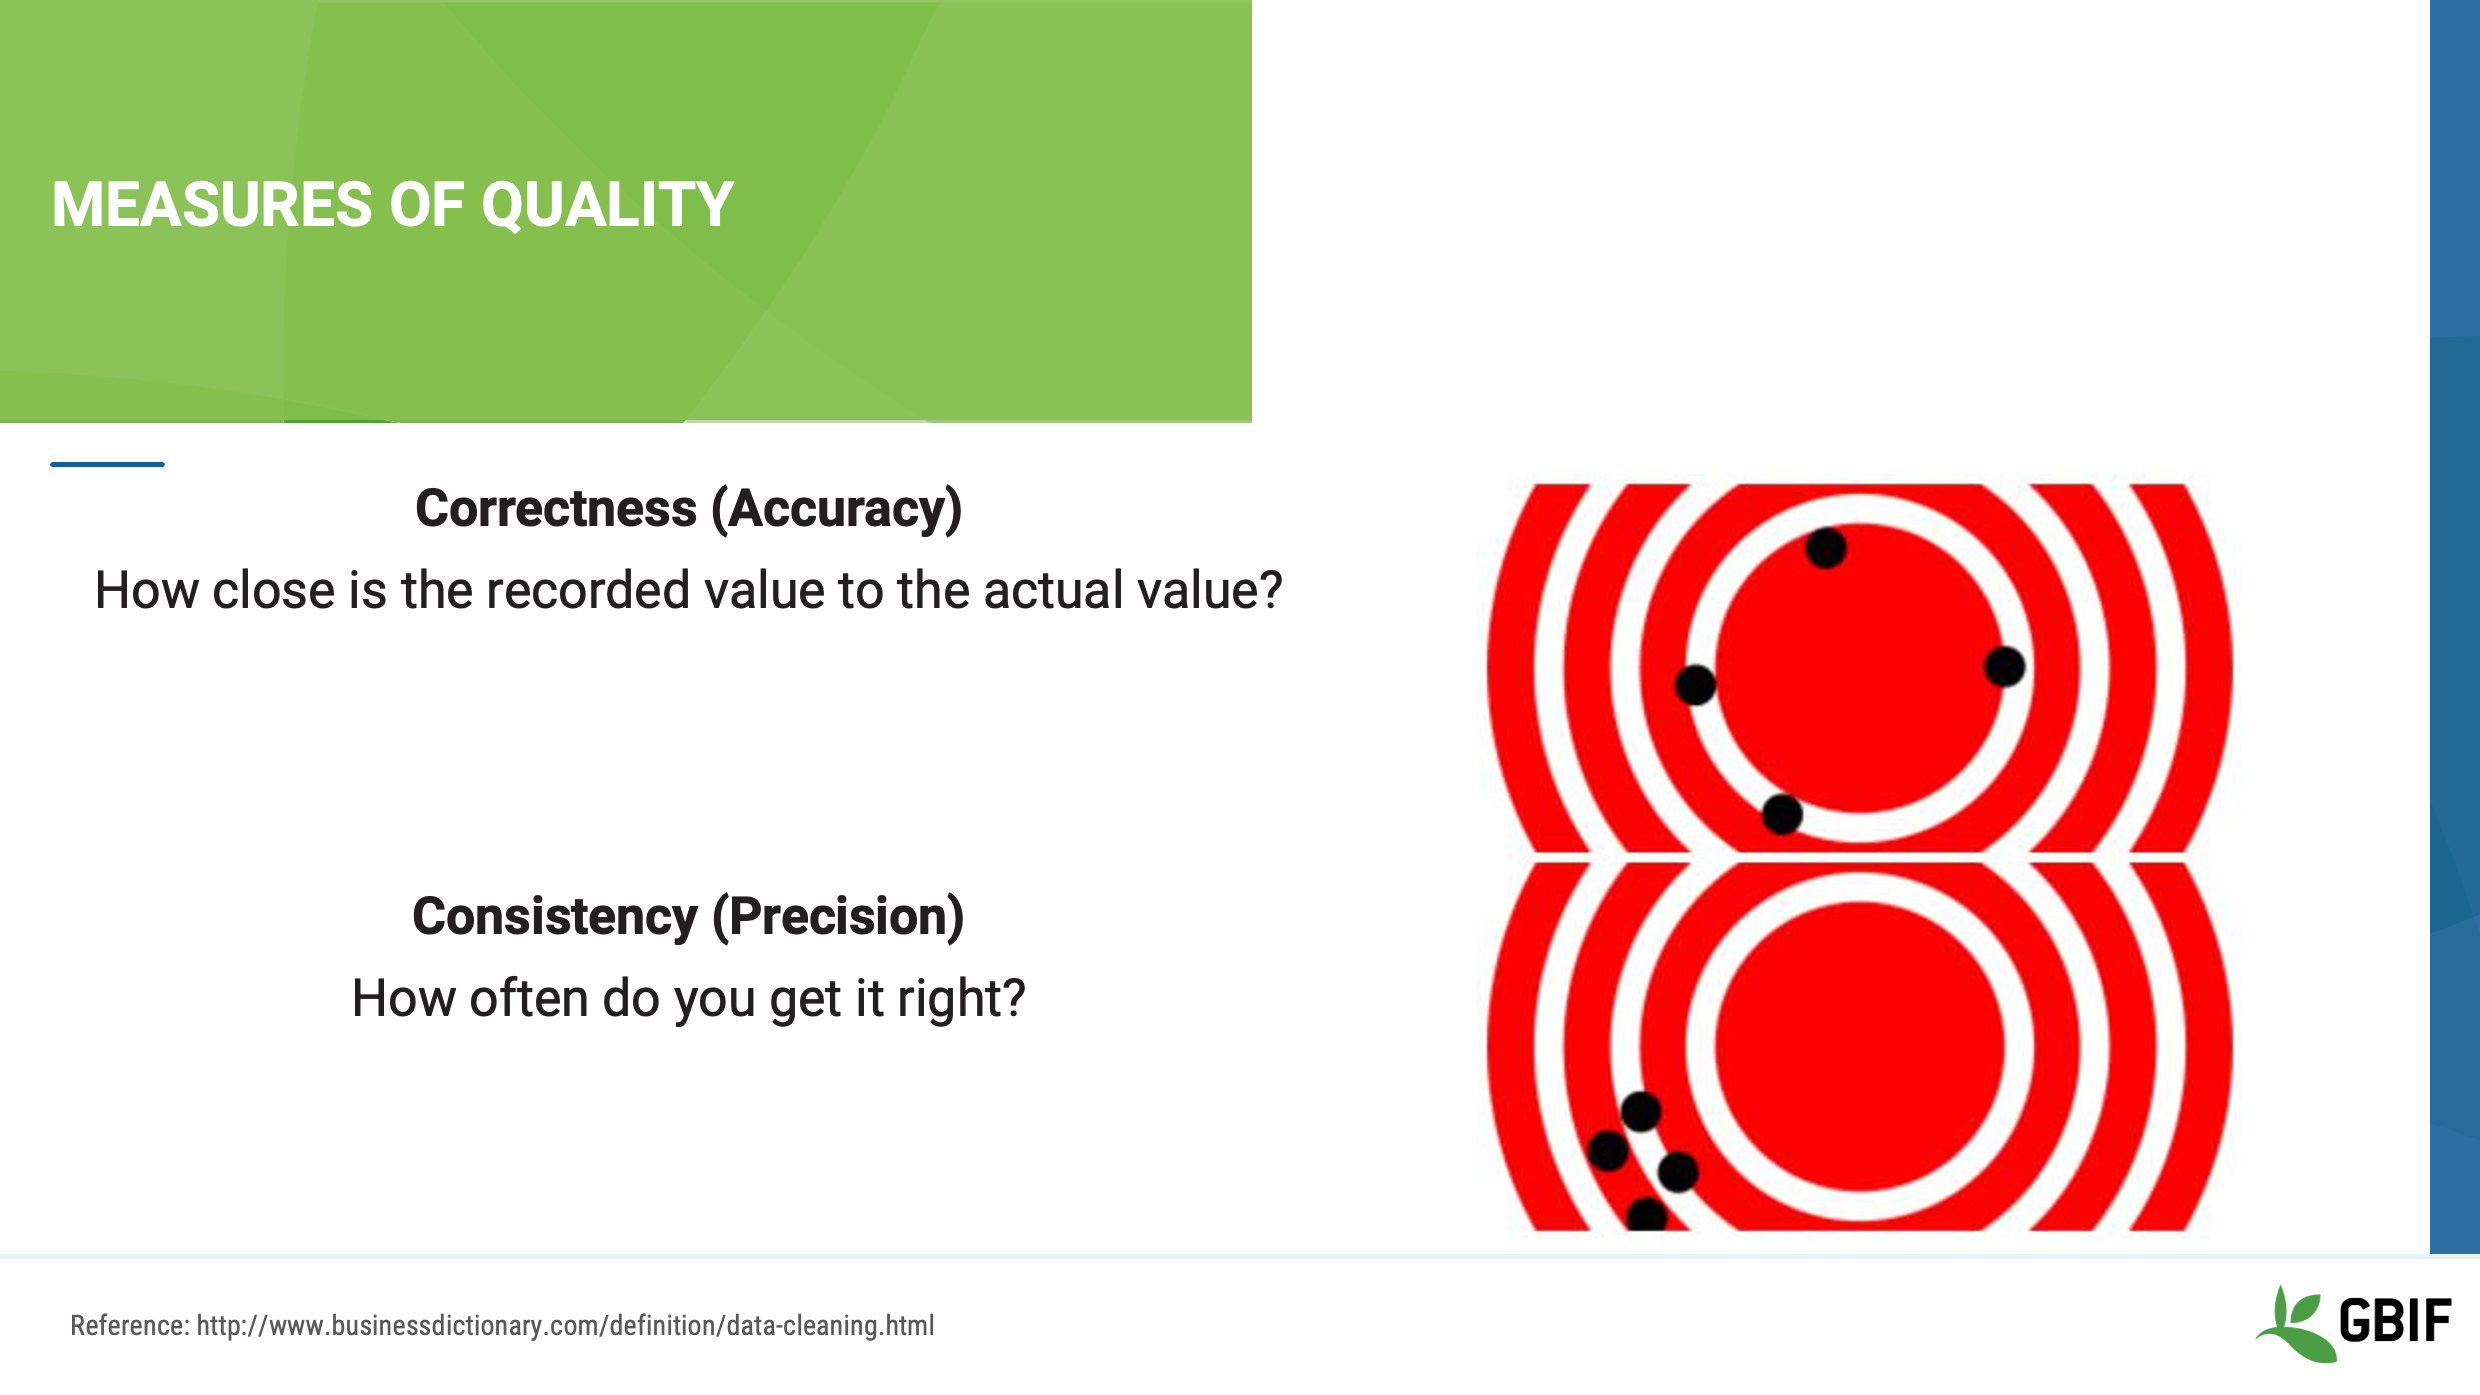
Для документирования неизбежно присутствующих в данных ошибок можно использовать два показателя качества: корректность и согласованность. Корректность, которую иногда также называют точностью, показывает, «насколько близко зарегистрированное значение к фактическому значению в реальном мире».
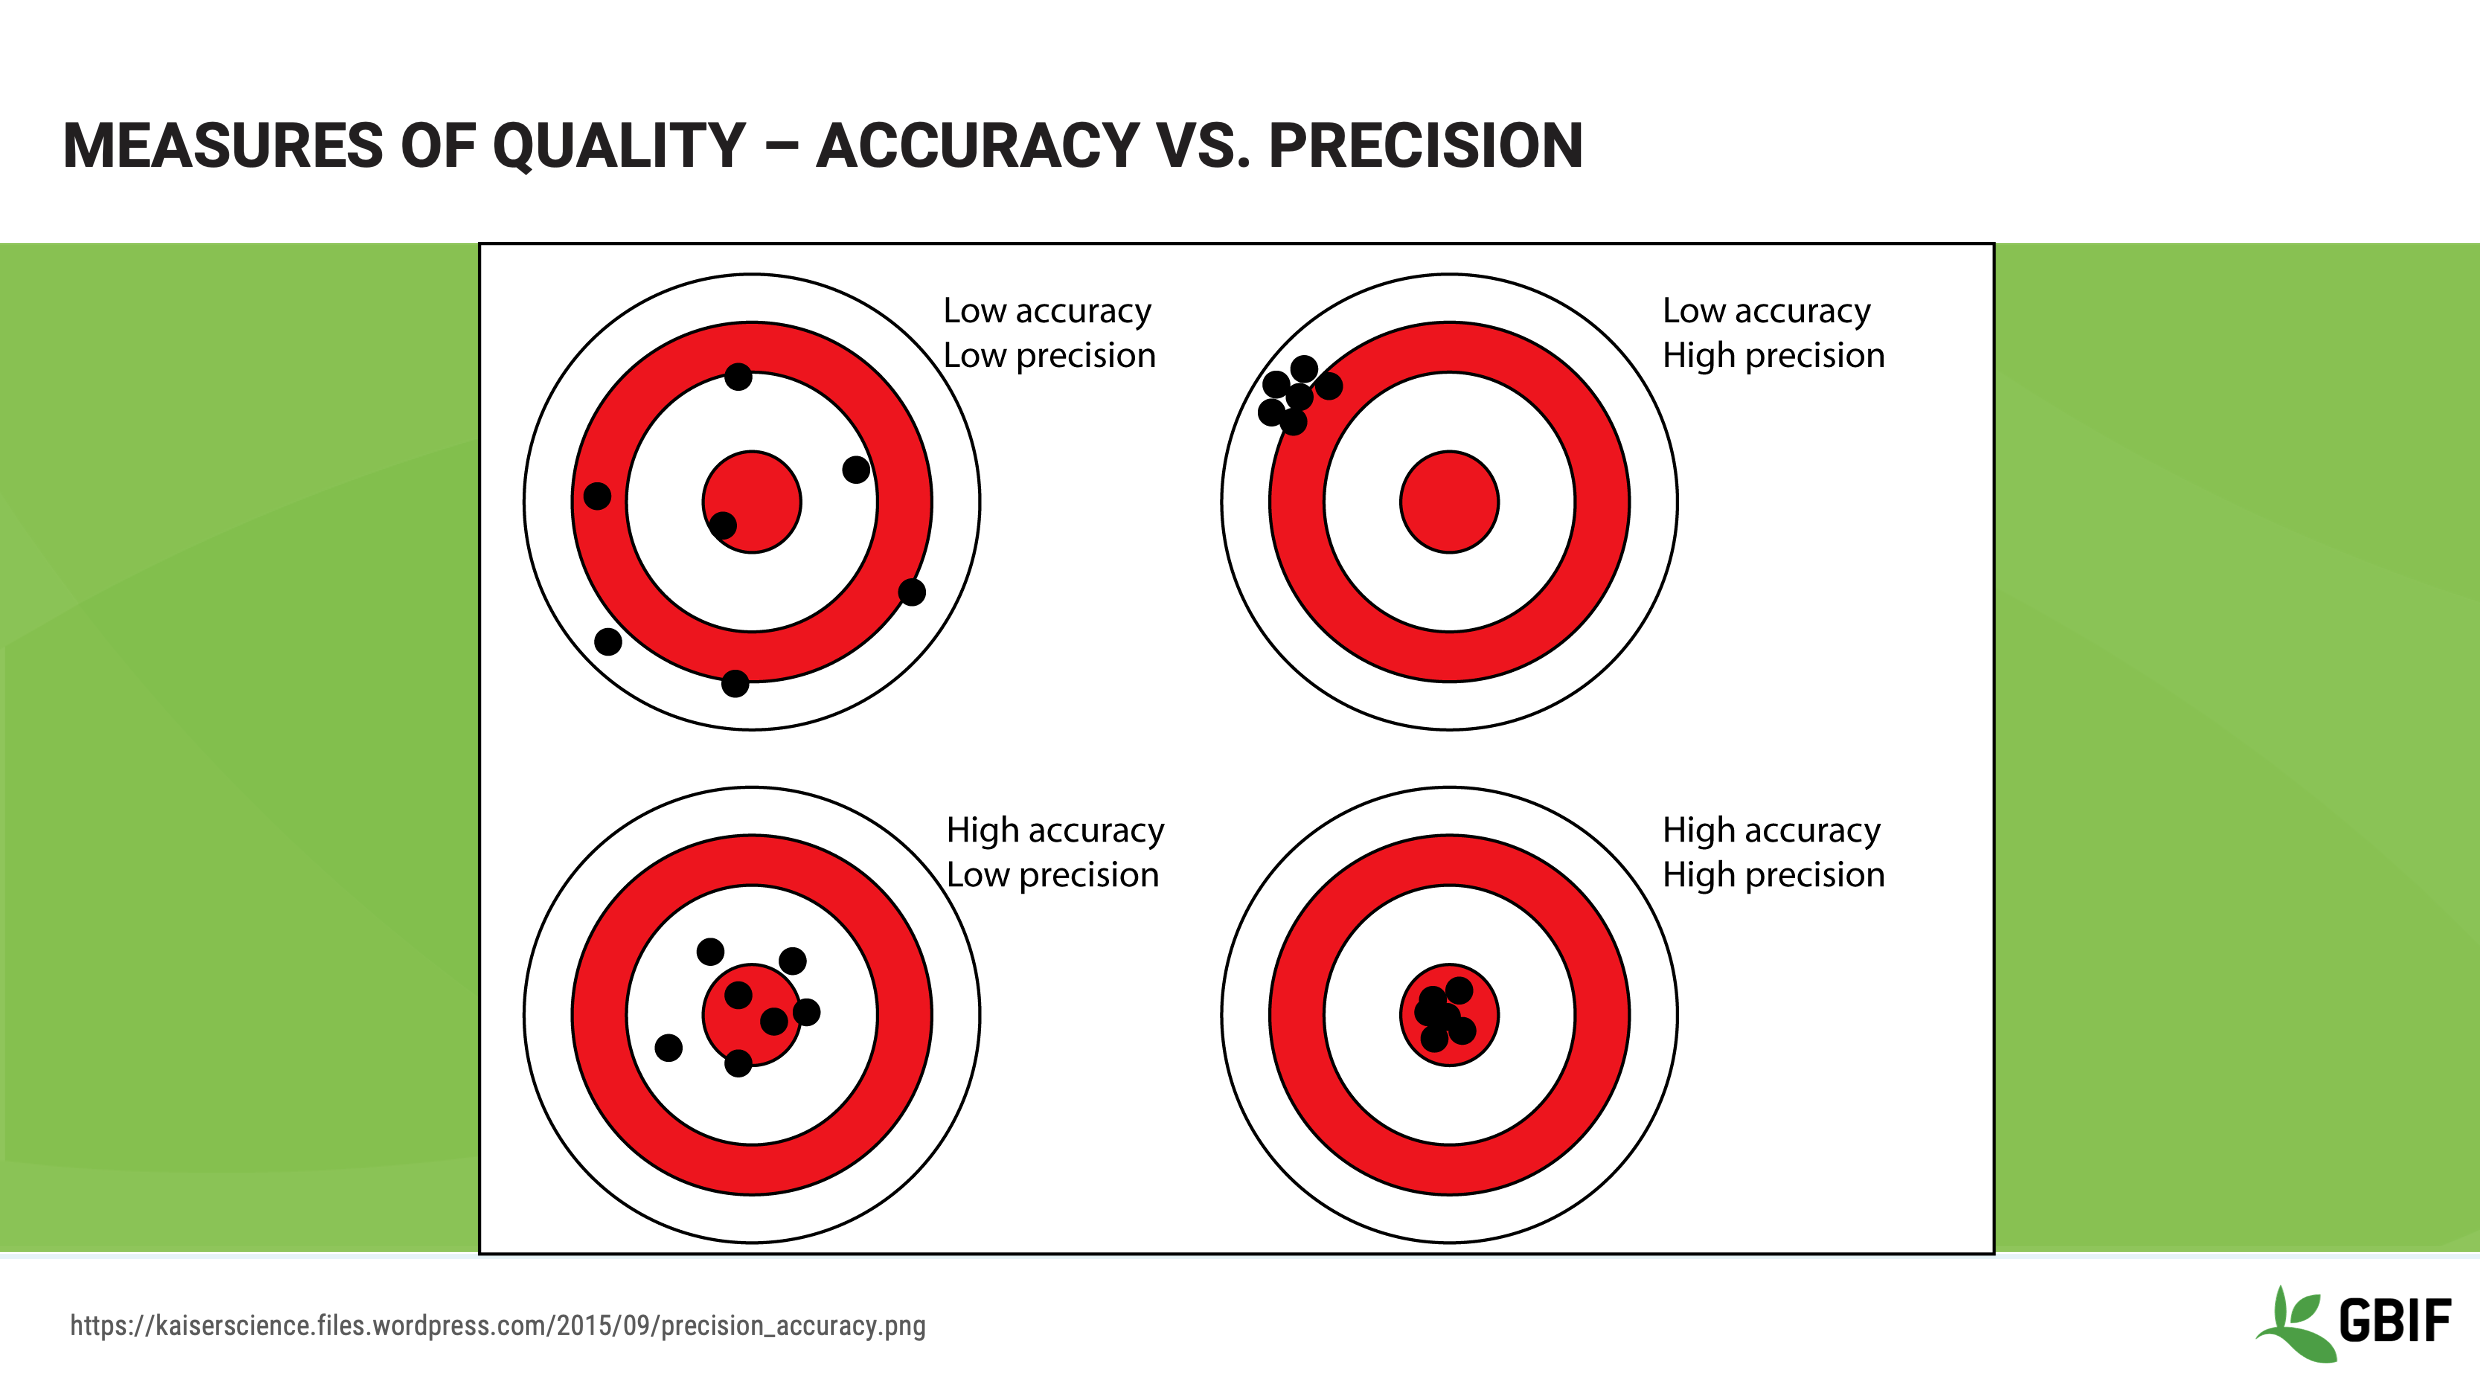
На этой диаграмме точность (accuracy) показывает, насколько близко конкретная точка расположена к центру мишени. Согласованность (consistency), которую иногда также называют прецизионностью (precision), показывает, «насколько часто вы получаете правильный результат»
На этой диаграмме прецизионность (precision) показывает, насколько близко точки расположены друг к другу, независимо от того, насколько близко они находятся к центру мишени. Эти показатели характеризуют, насколько точно сборщик данных смог зафиксировать истинное значение исследуемого параметра. Знание этих характеристик ваших данных поможет понять, какие методы очистки, проверки и обработки данных можно применять, а какие — нет.
Слайд 13 — Показатели качества — Точность и прецизионность
На этом изображении наглядно представлены понятия точности (accuracy) и прецизионности (precision). Возможно, его стоит сохранить, чтобы использовать при объяснении этих понятий другим.
Источник изображения: https://kaiserscience.files.wordpress.com/2015/09/precision_accuracy.png

Слайд 14 — Показатели качества — Корректность
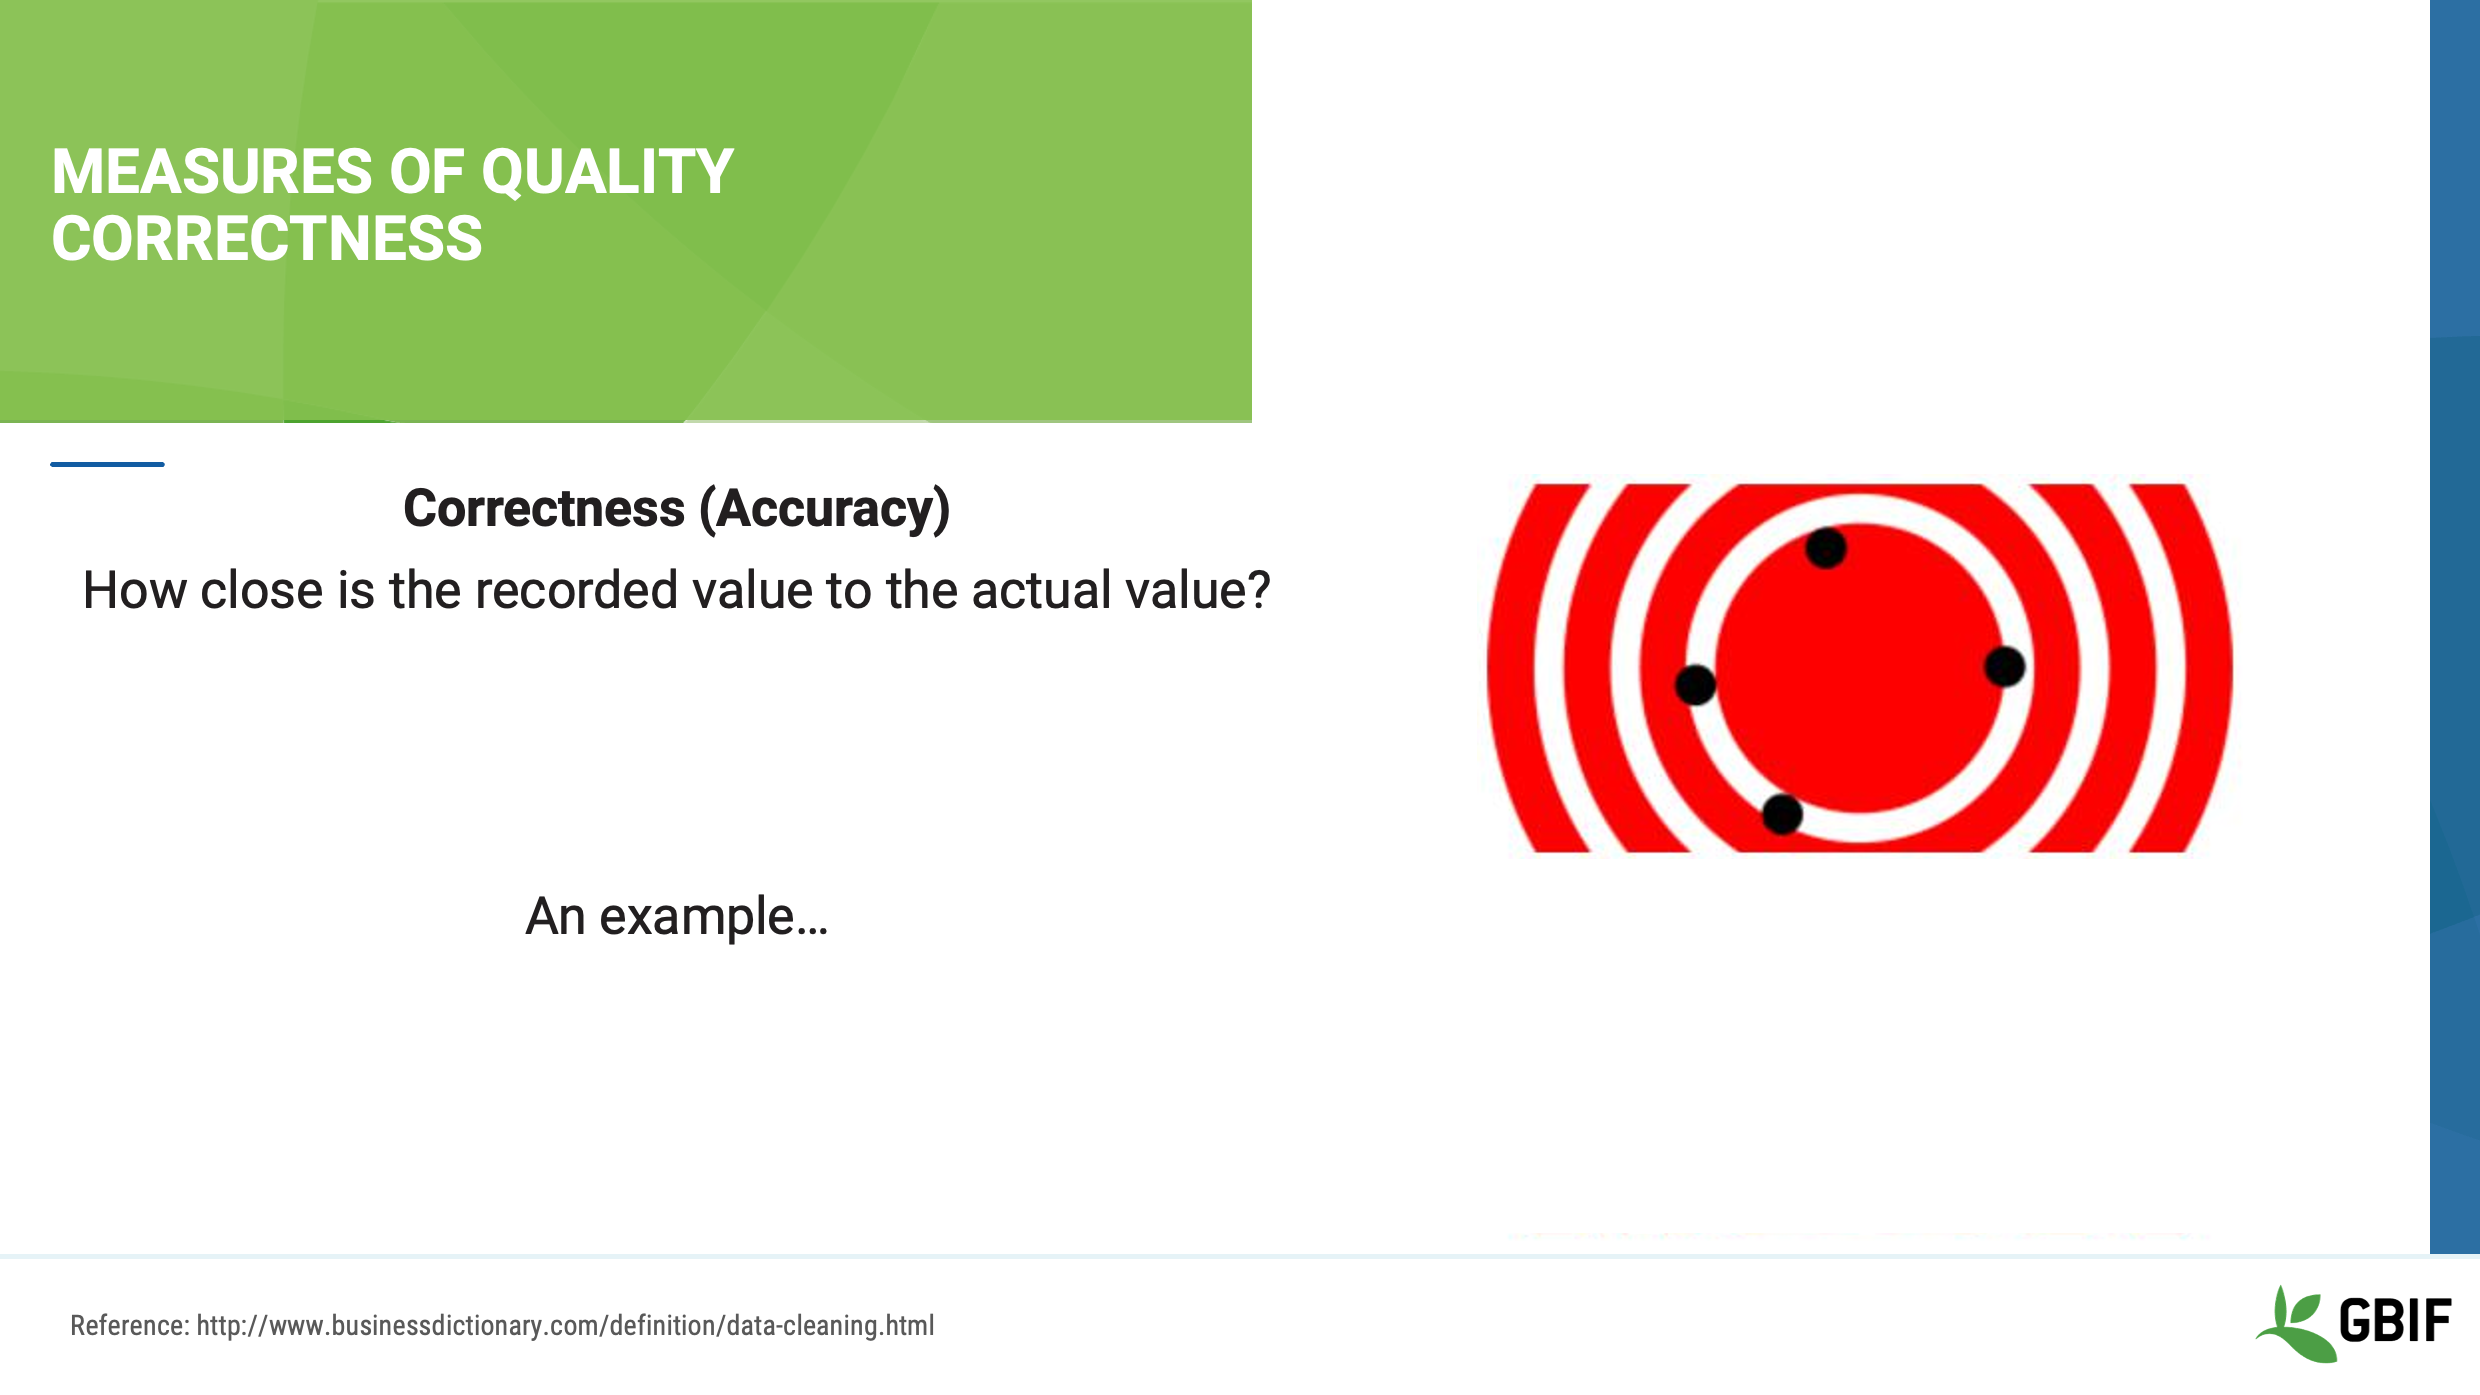
Рассмотрим несколько примеров корректности (correctness), или точности (accuracy), и то, как это понятие помогает нам понять практические аспекты очистки данных. Напомним, что корректность показывает, насколько близко значение находится к центру мишени. Рассмотрим пример.
Слайд 15 — Показатели качества — Корректность: пример 1
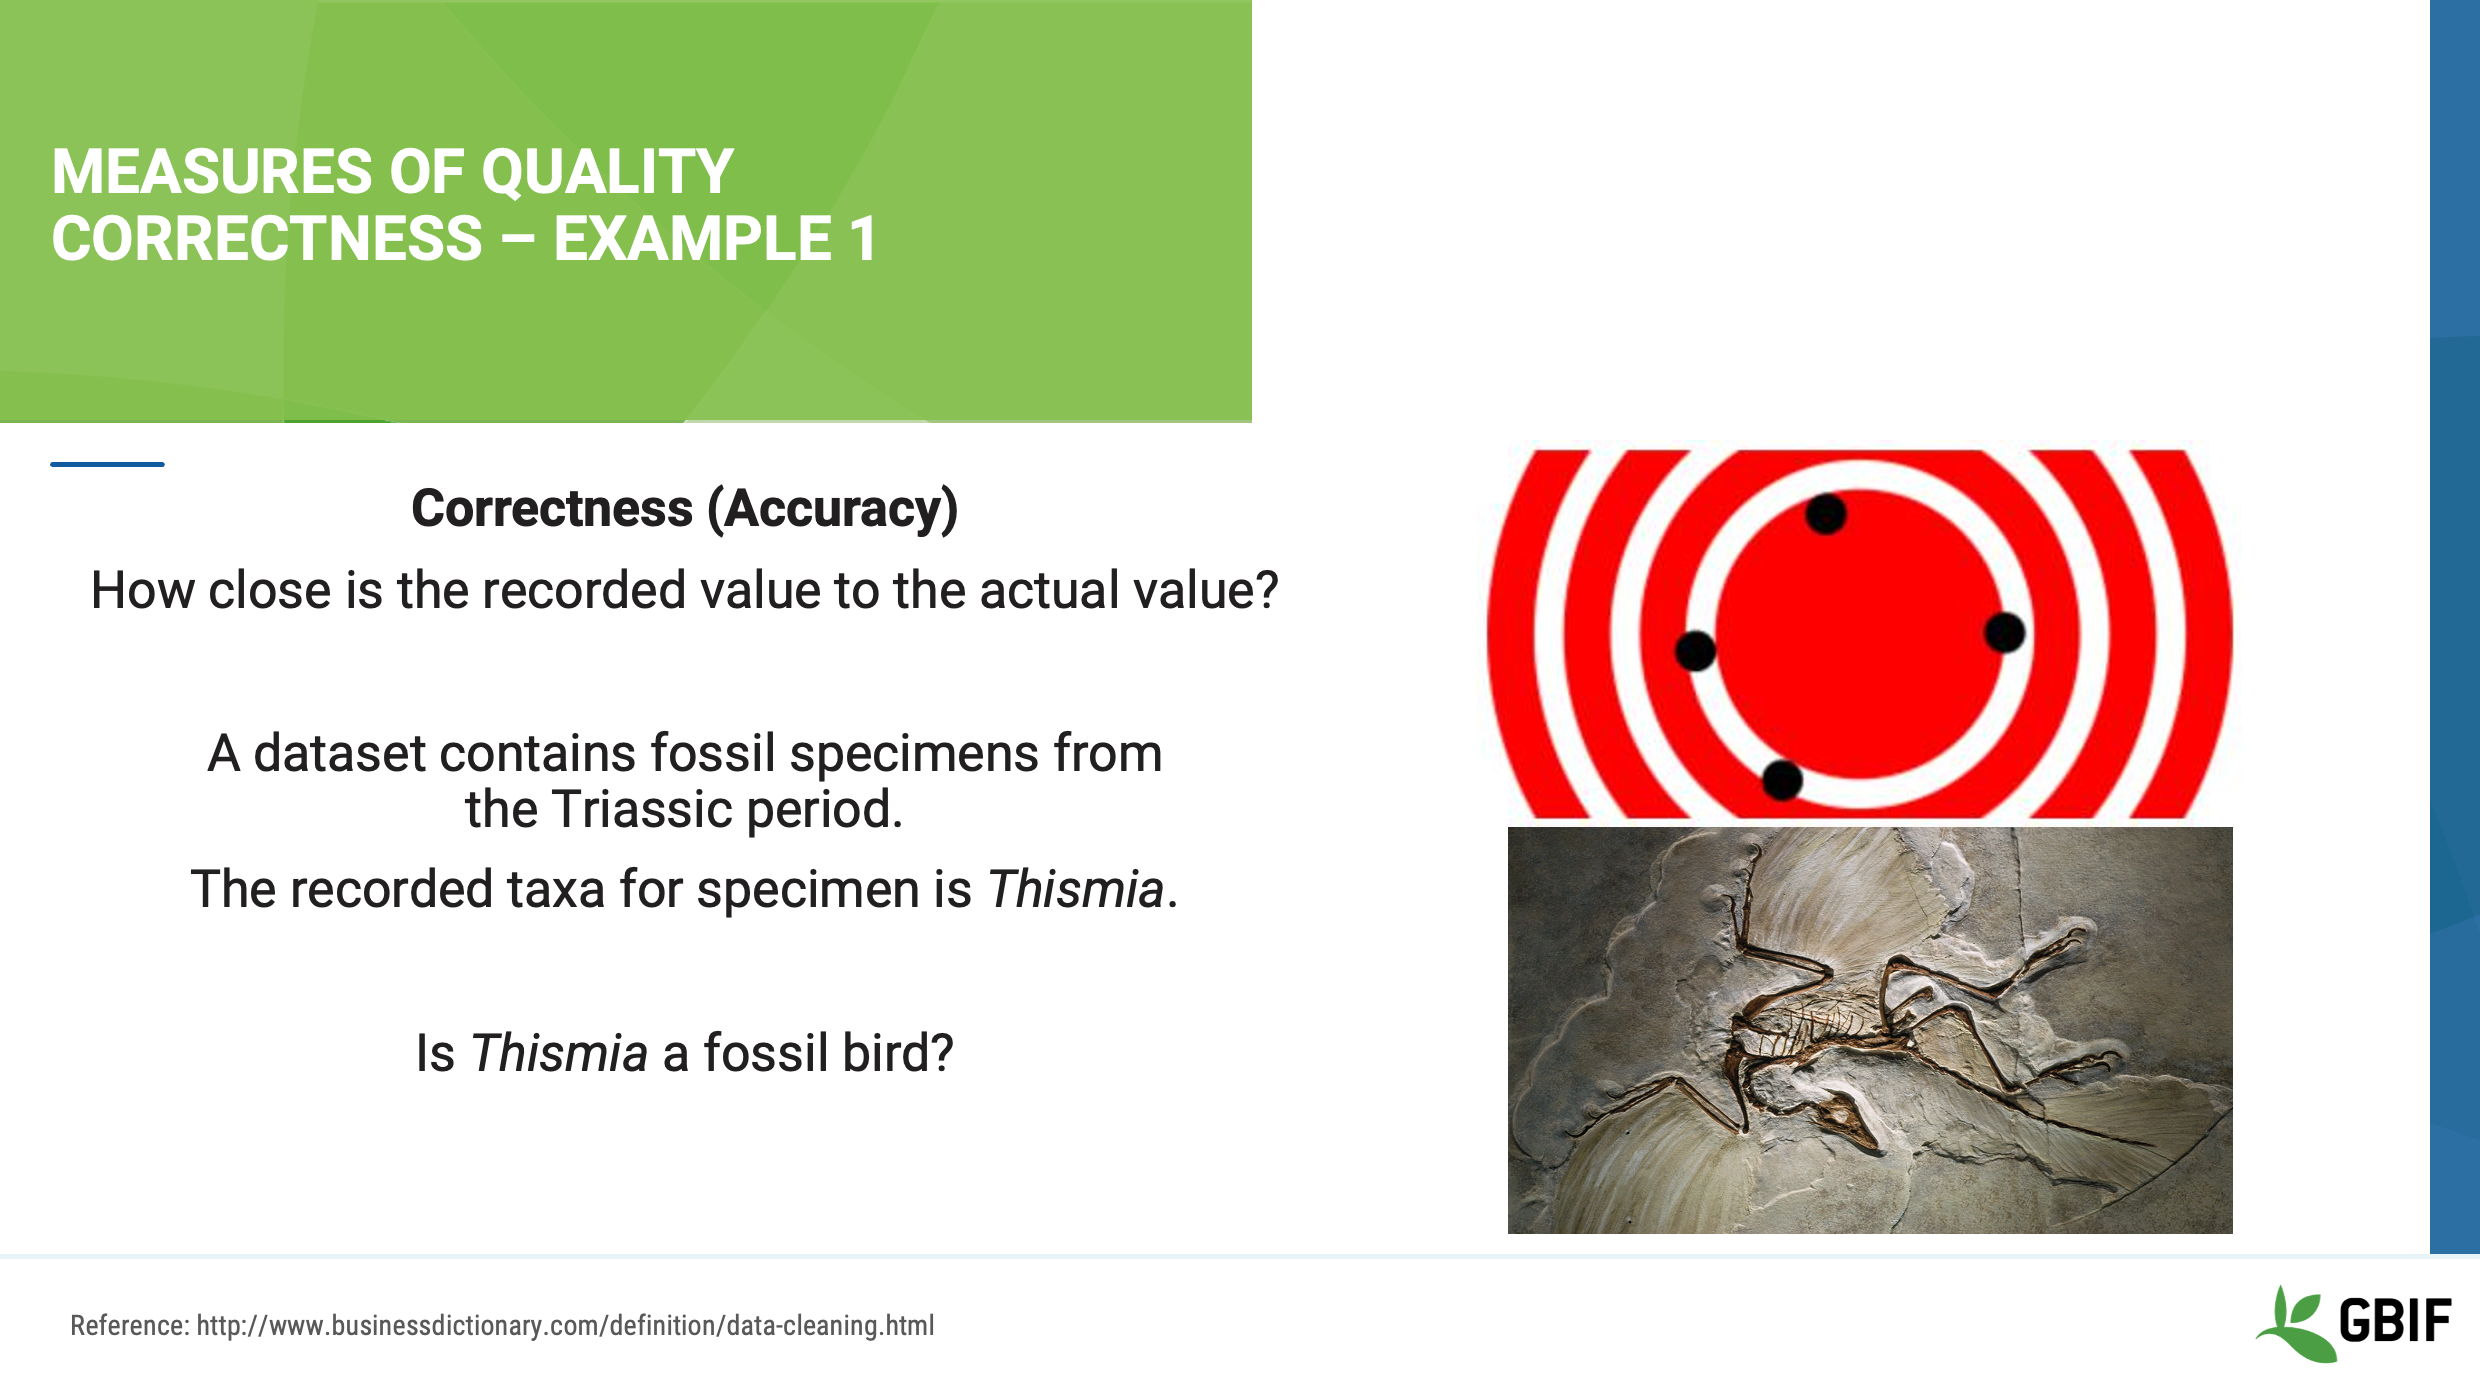
Для этого примера представим, что ваш набор данных содержит записи об ископаемых образцах птиц раннего триасового периода. Для ряда образцов в наборе данных в качестве таксономического названия указано Thismia. Знаете ли вы, является ли Thismia таксоном древних птиц? Источник изображения: https://commons.wikimedia.org/wiki/File:Archaeopteryx_fossil.jpg

Слайд 16 — Показатели качества — Корректность: пример 1
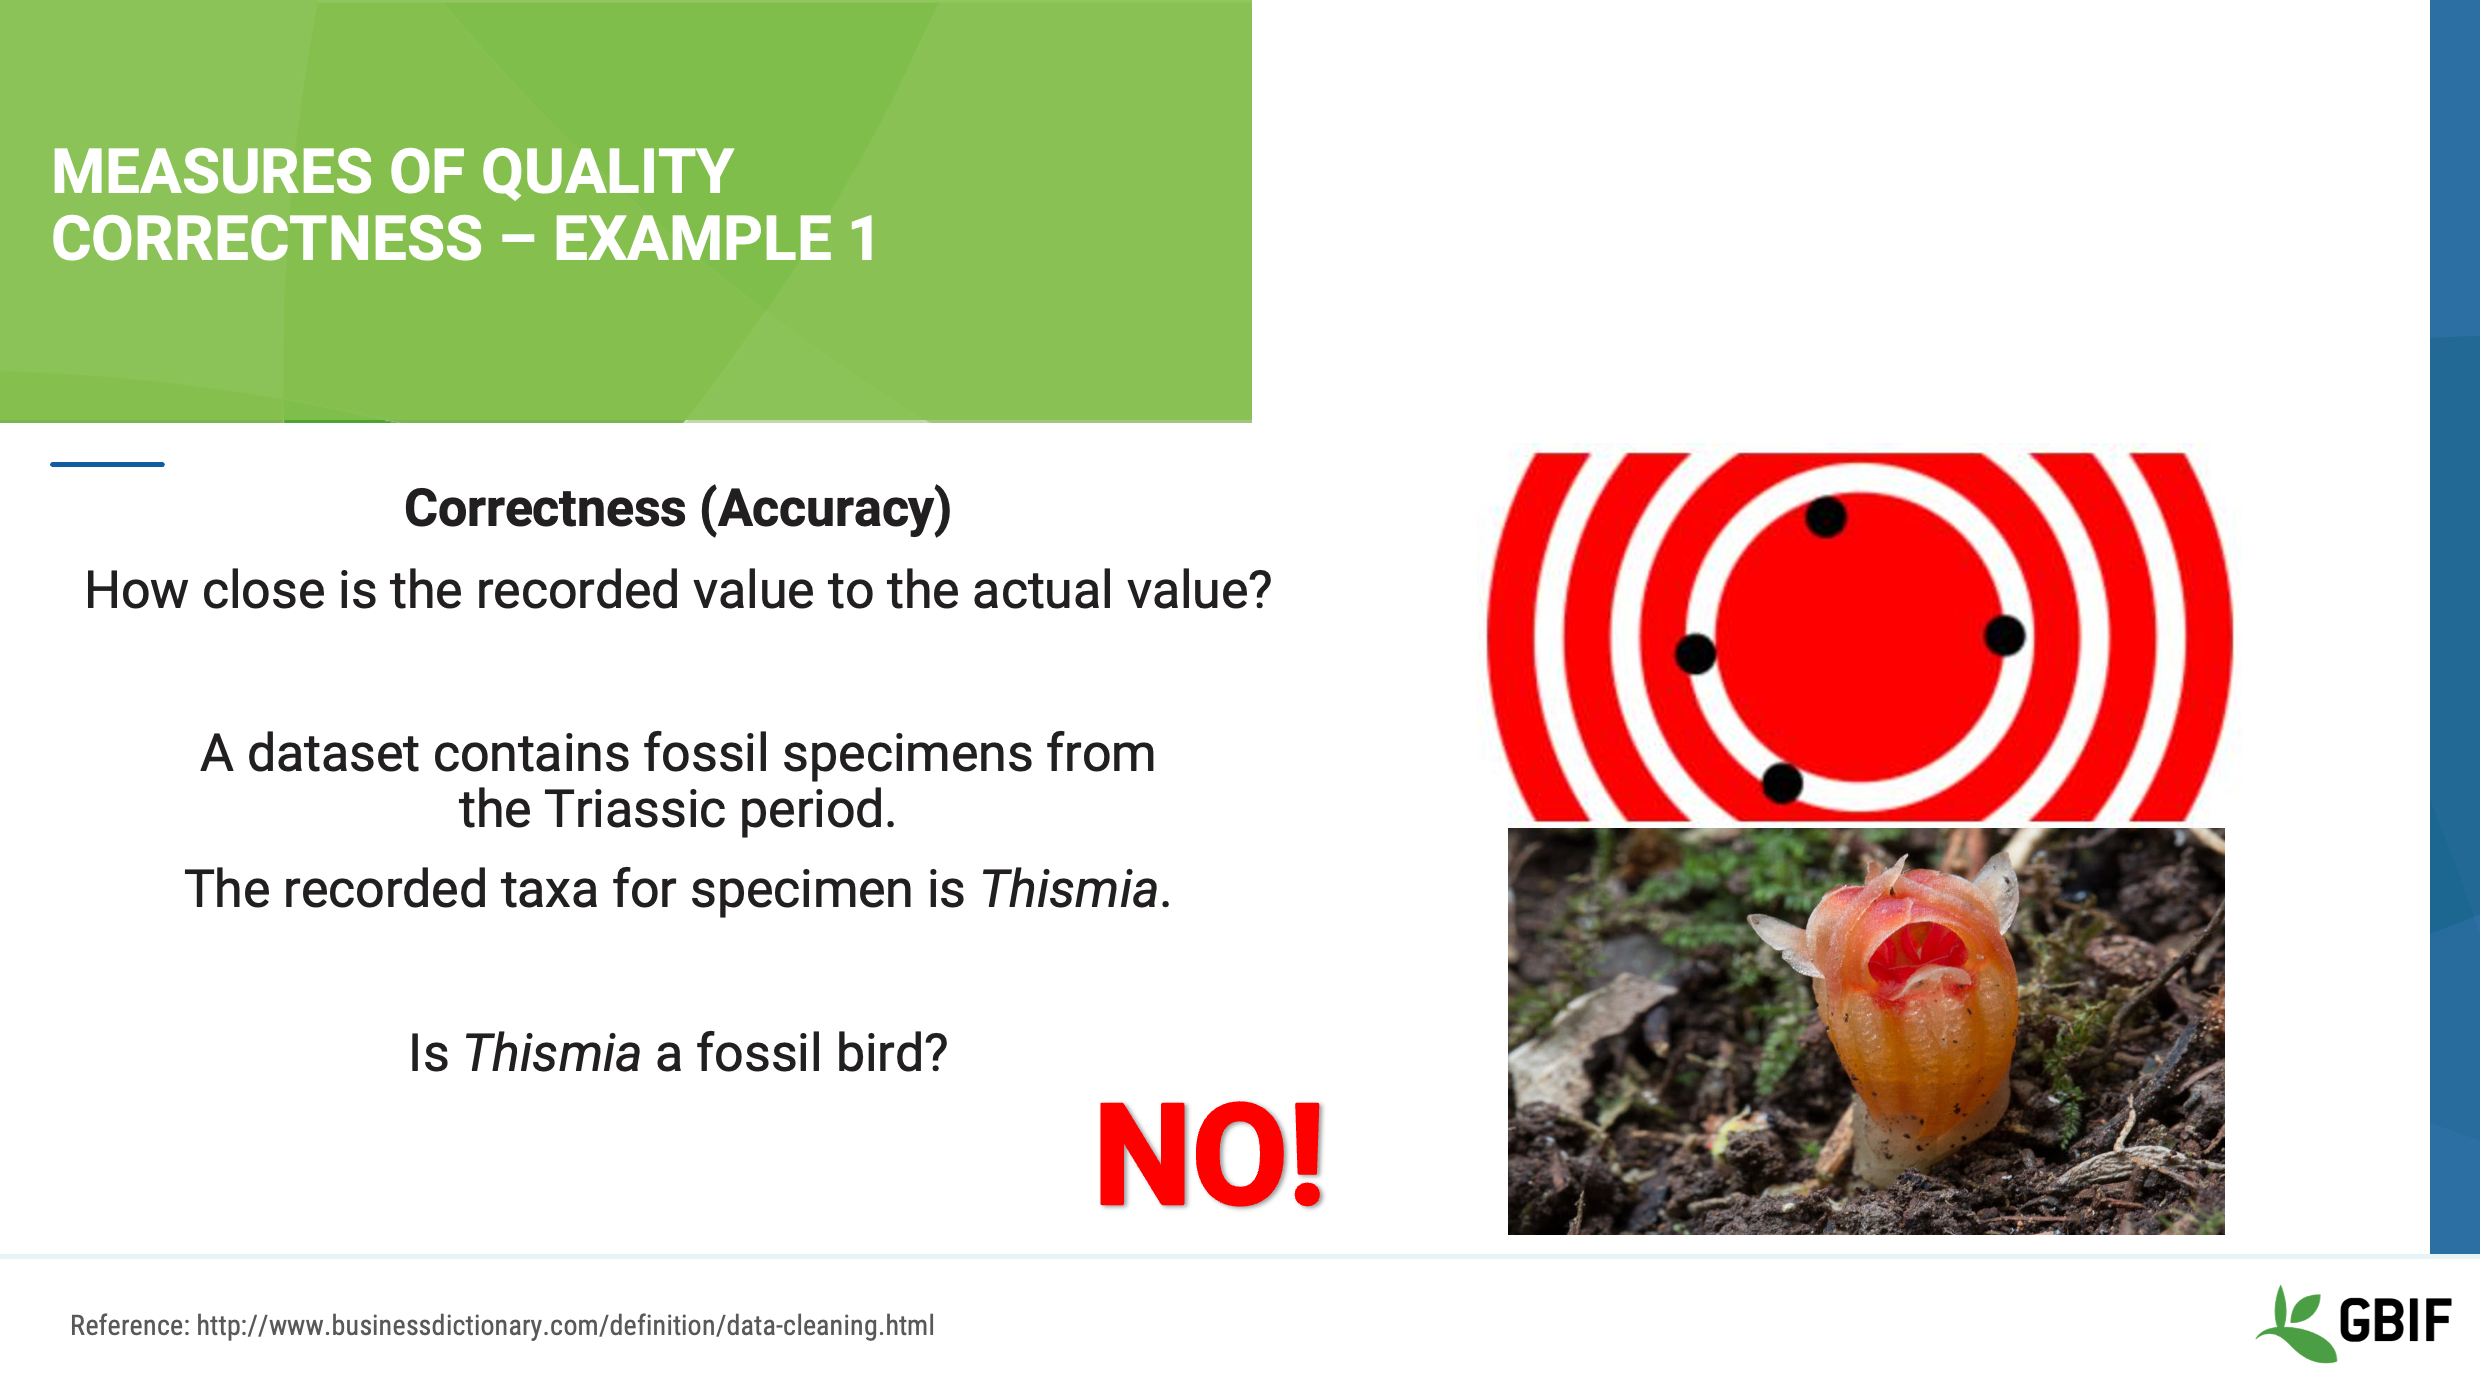
В данном случае ответ — нет! Тисмия — очень редкое растение, произрастающее в штате Иллинойс в США. Следовательно, корректность, или точность, таксономического названия в данном случае низкая. Возможно, это связано с тем, что оператор ввода данных не был специалистом по палеонтологии. Поэтому перед использованием данных все названия в наборе данных, возможно, потребуется проверить и исправить с привлечением специалиста. Фото: GBIF: (н/д) Thismia rodwayi Правообладатель: Tindo2 Лицензия: http://creativeco…censes/by-nc/4.0/ Ссылка (нет данных): https://www.inaturalist.org/photos/596775?size=large
Слайд 17 — Показатели качества — Корректность: пример 2
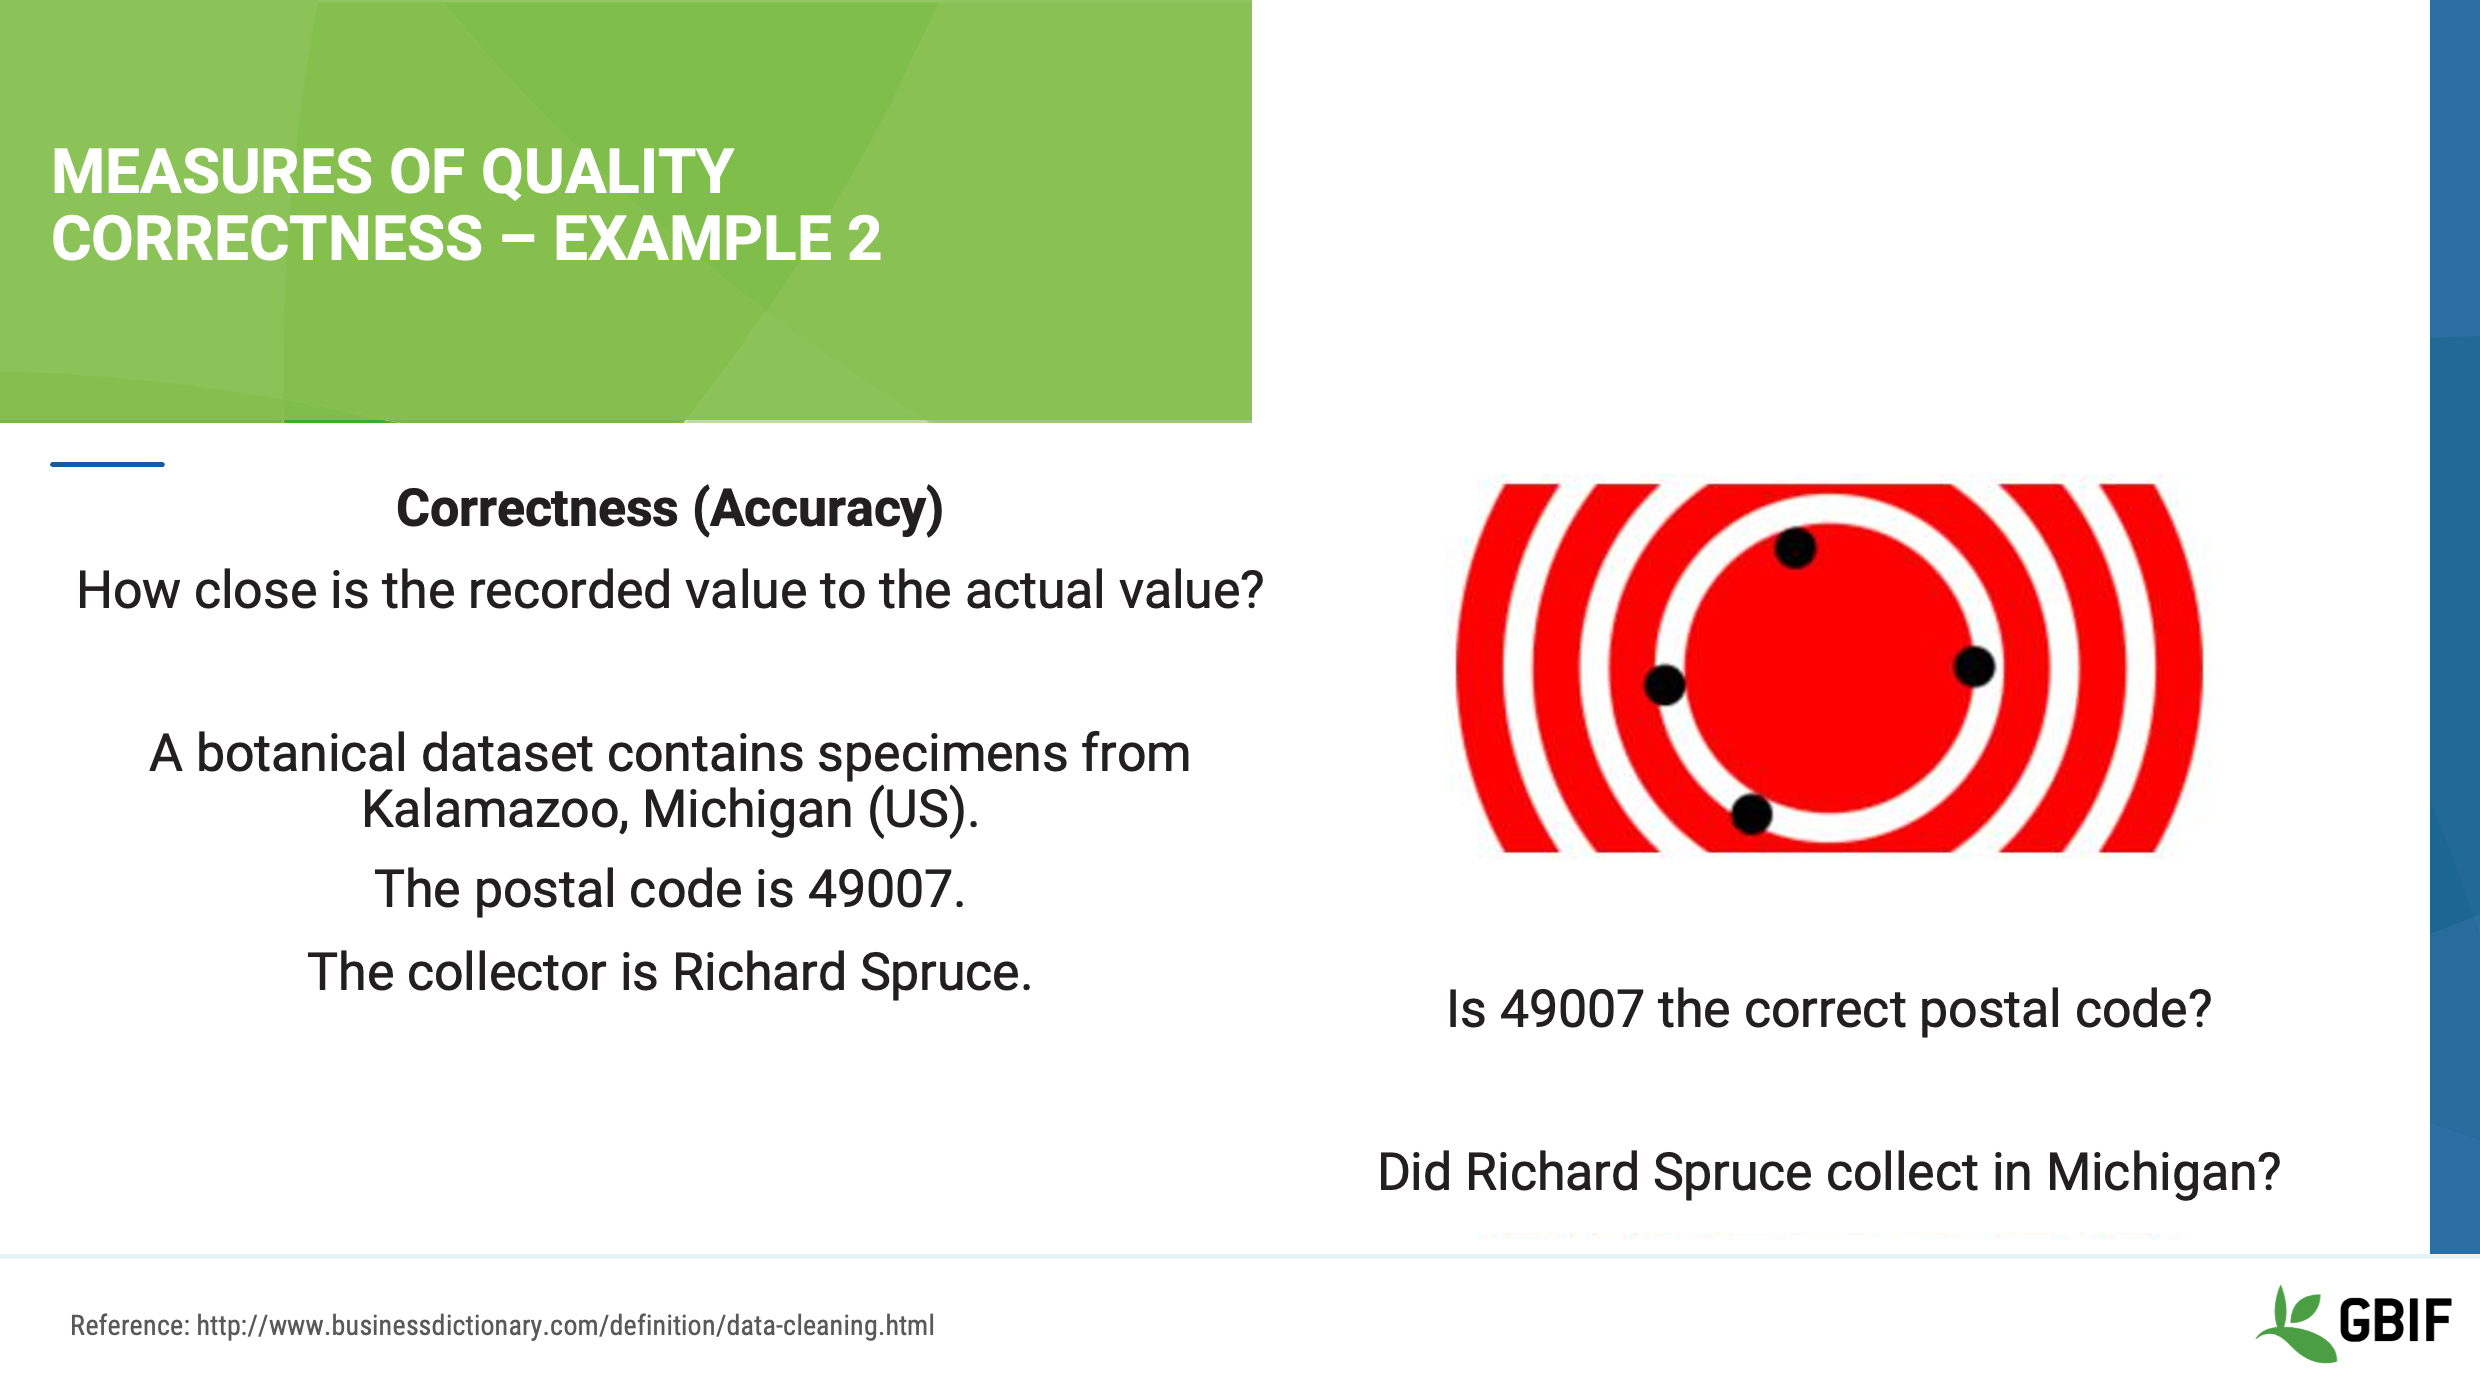
Рассмотрим ещё один пример. В данном случае ваш набор данных содержит образцы, собранные в местности под названием Каламазу (Kalamazoo) исследователем по имени Ричард Спрус (Richard Spruce). Мы должны задать себе вопрос:
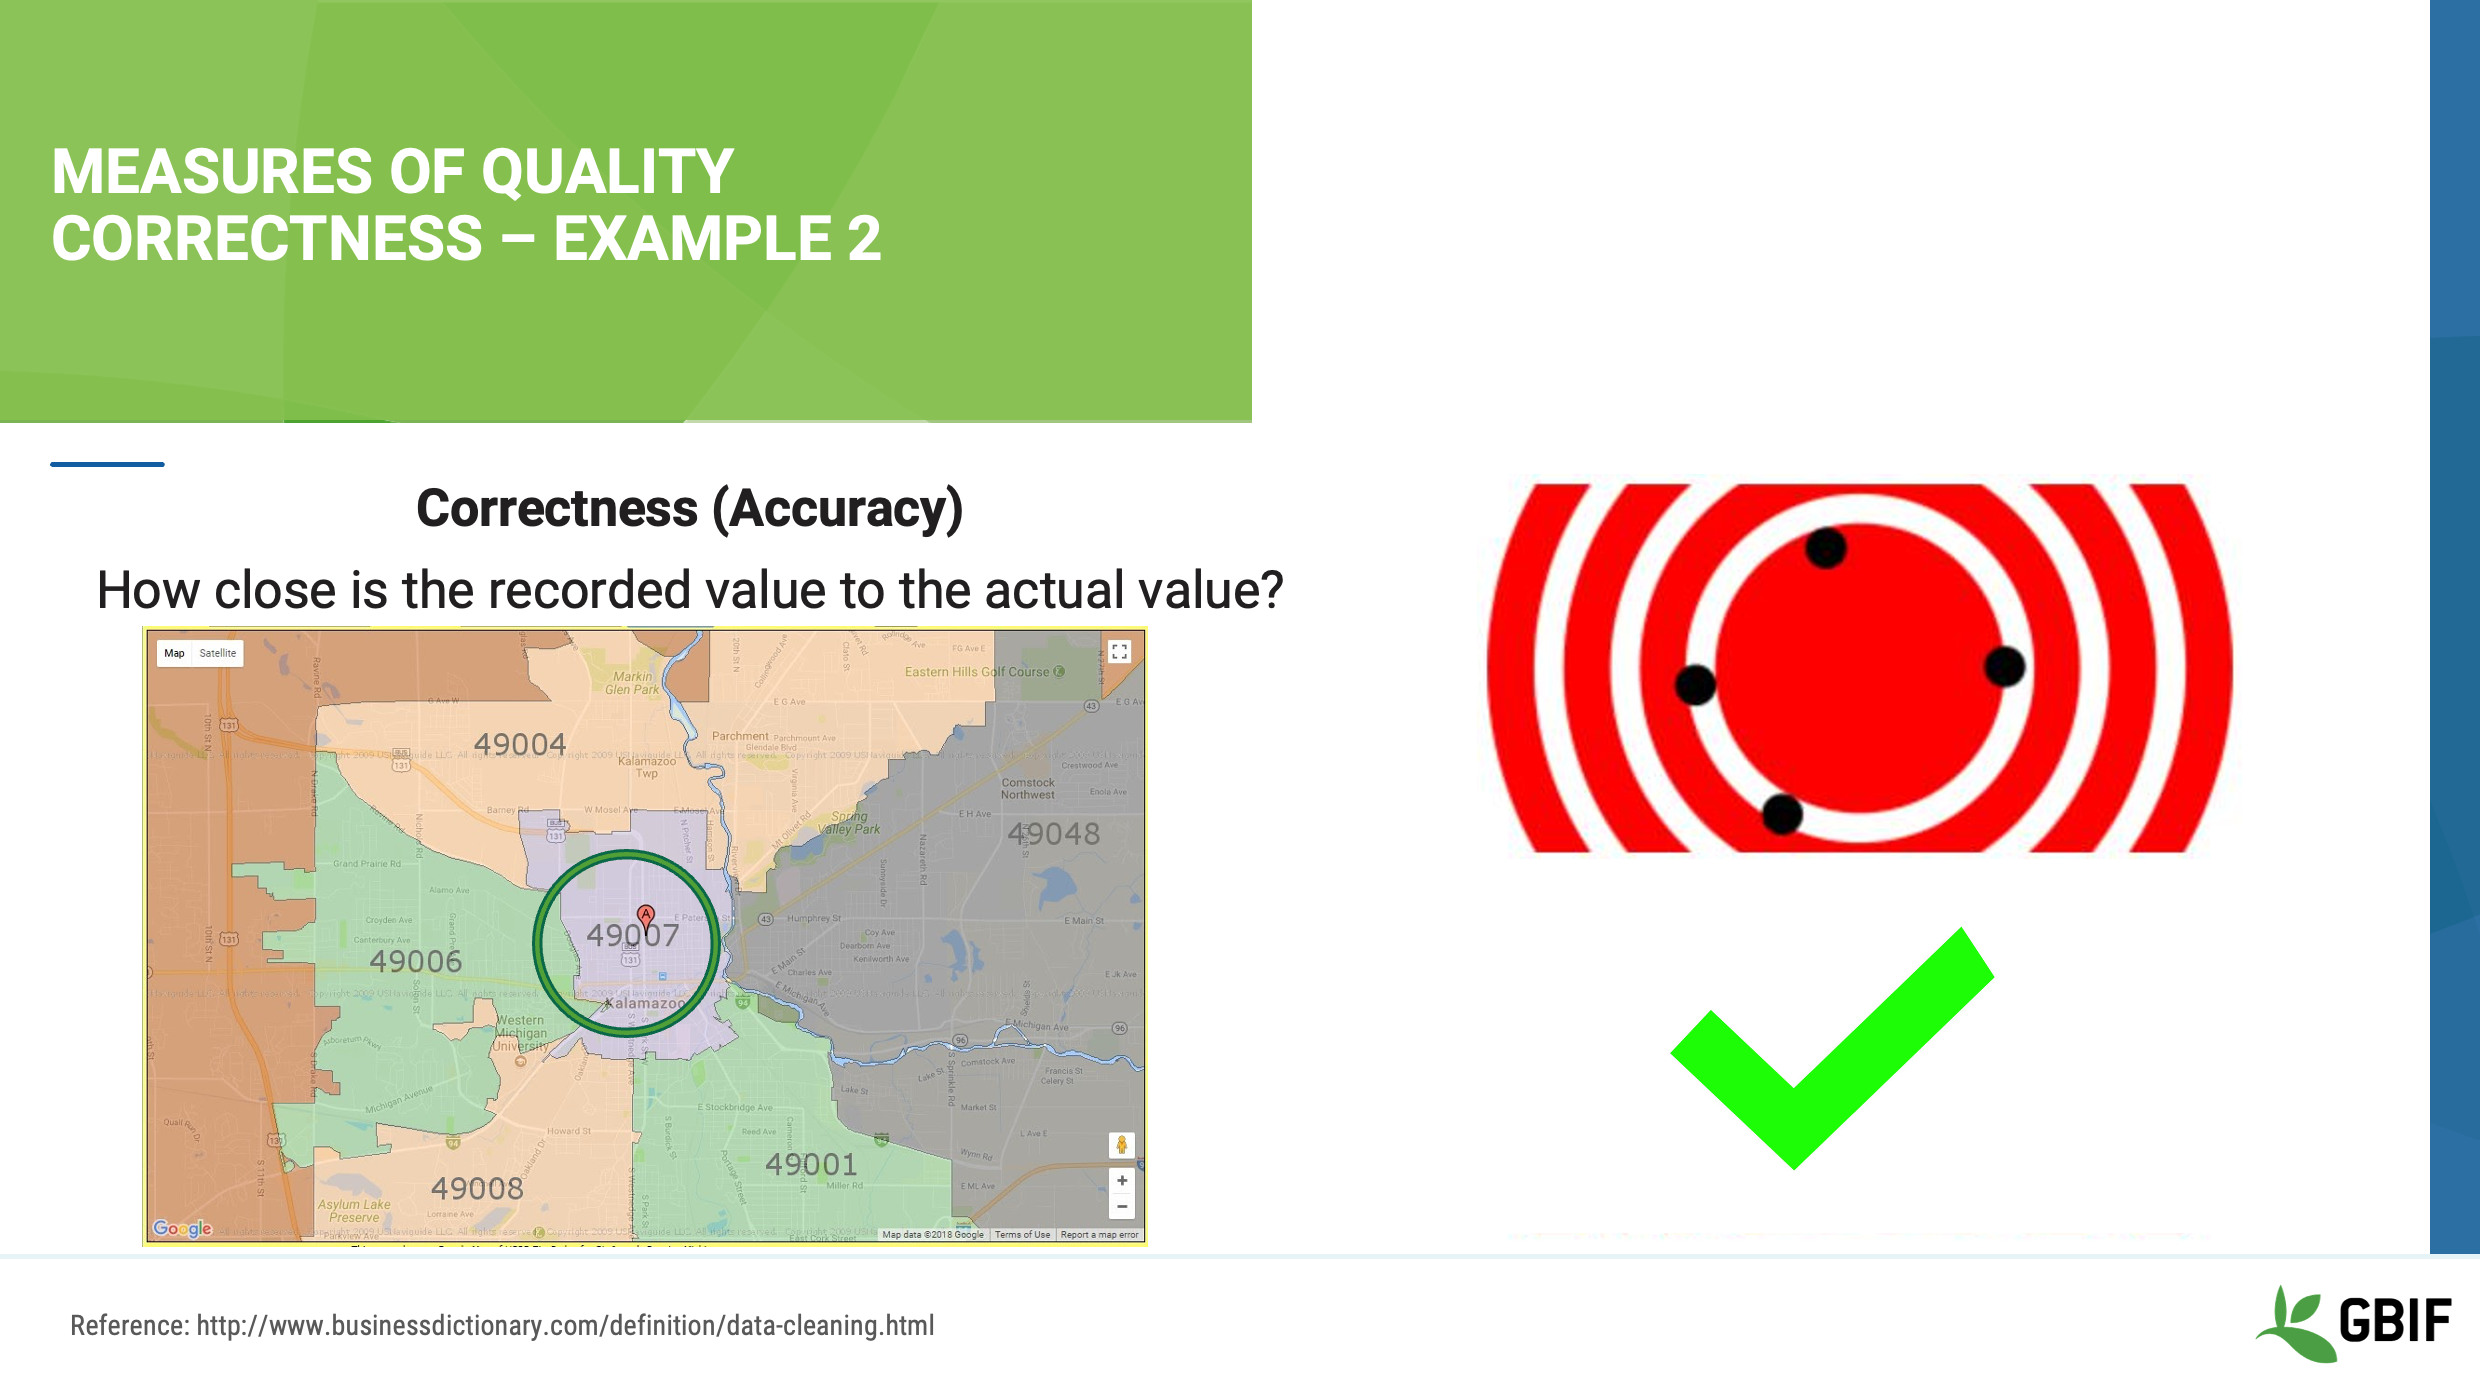
Является ли 49007 правильным почтовым индексом для Каламазу?
Ричард Спрус занимался коллекционированием в Мичигане?
Слайд 18 — Показатели качества — Корректность: пример 2
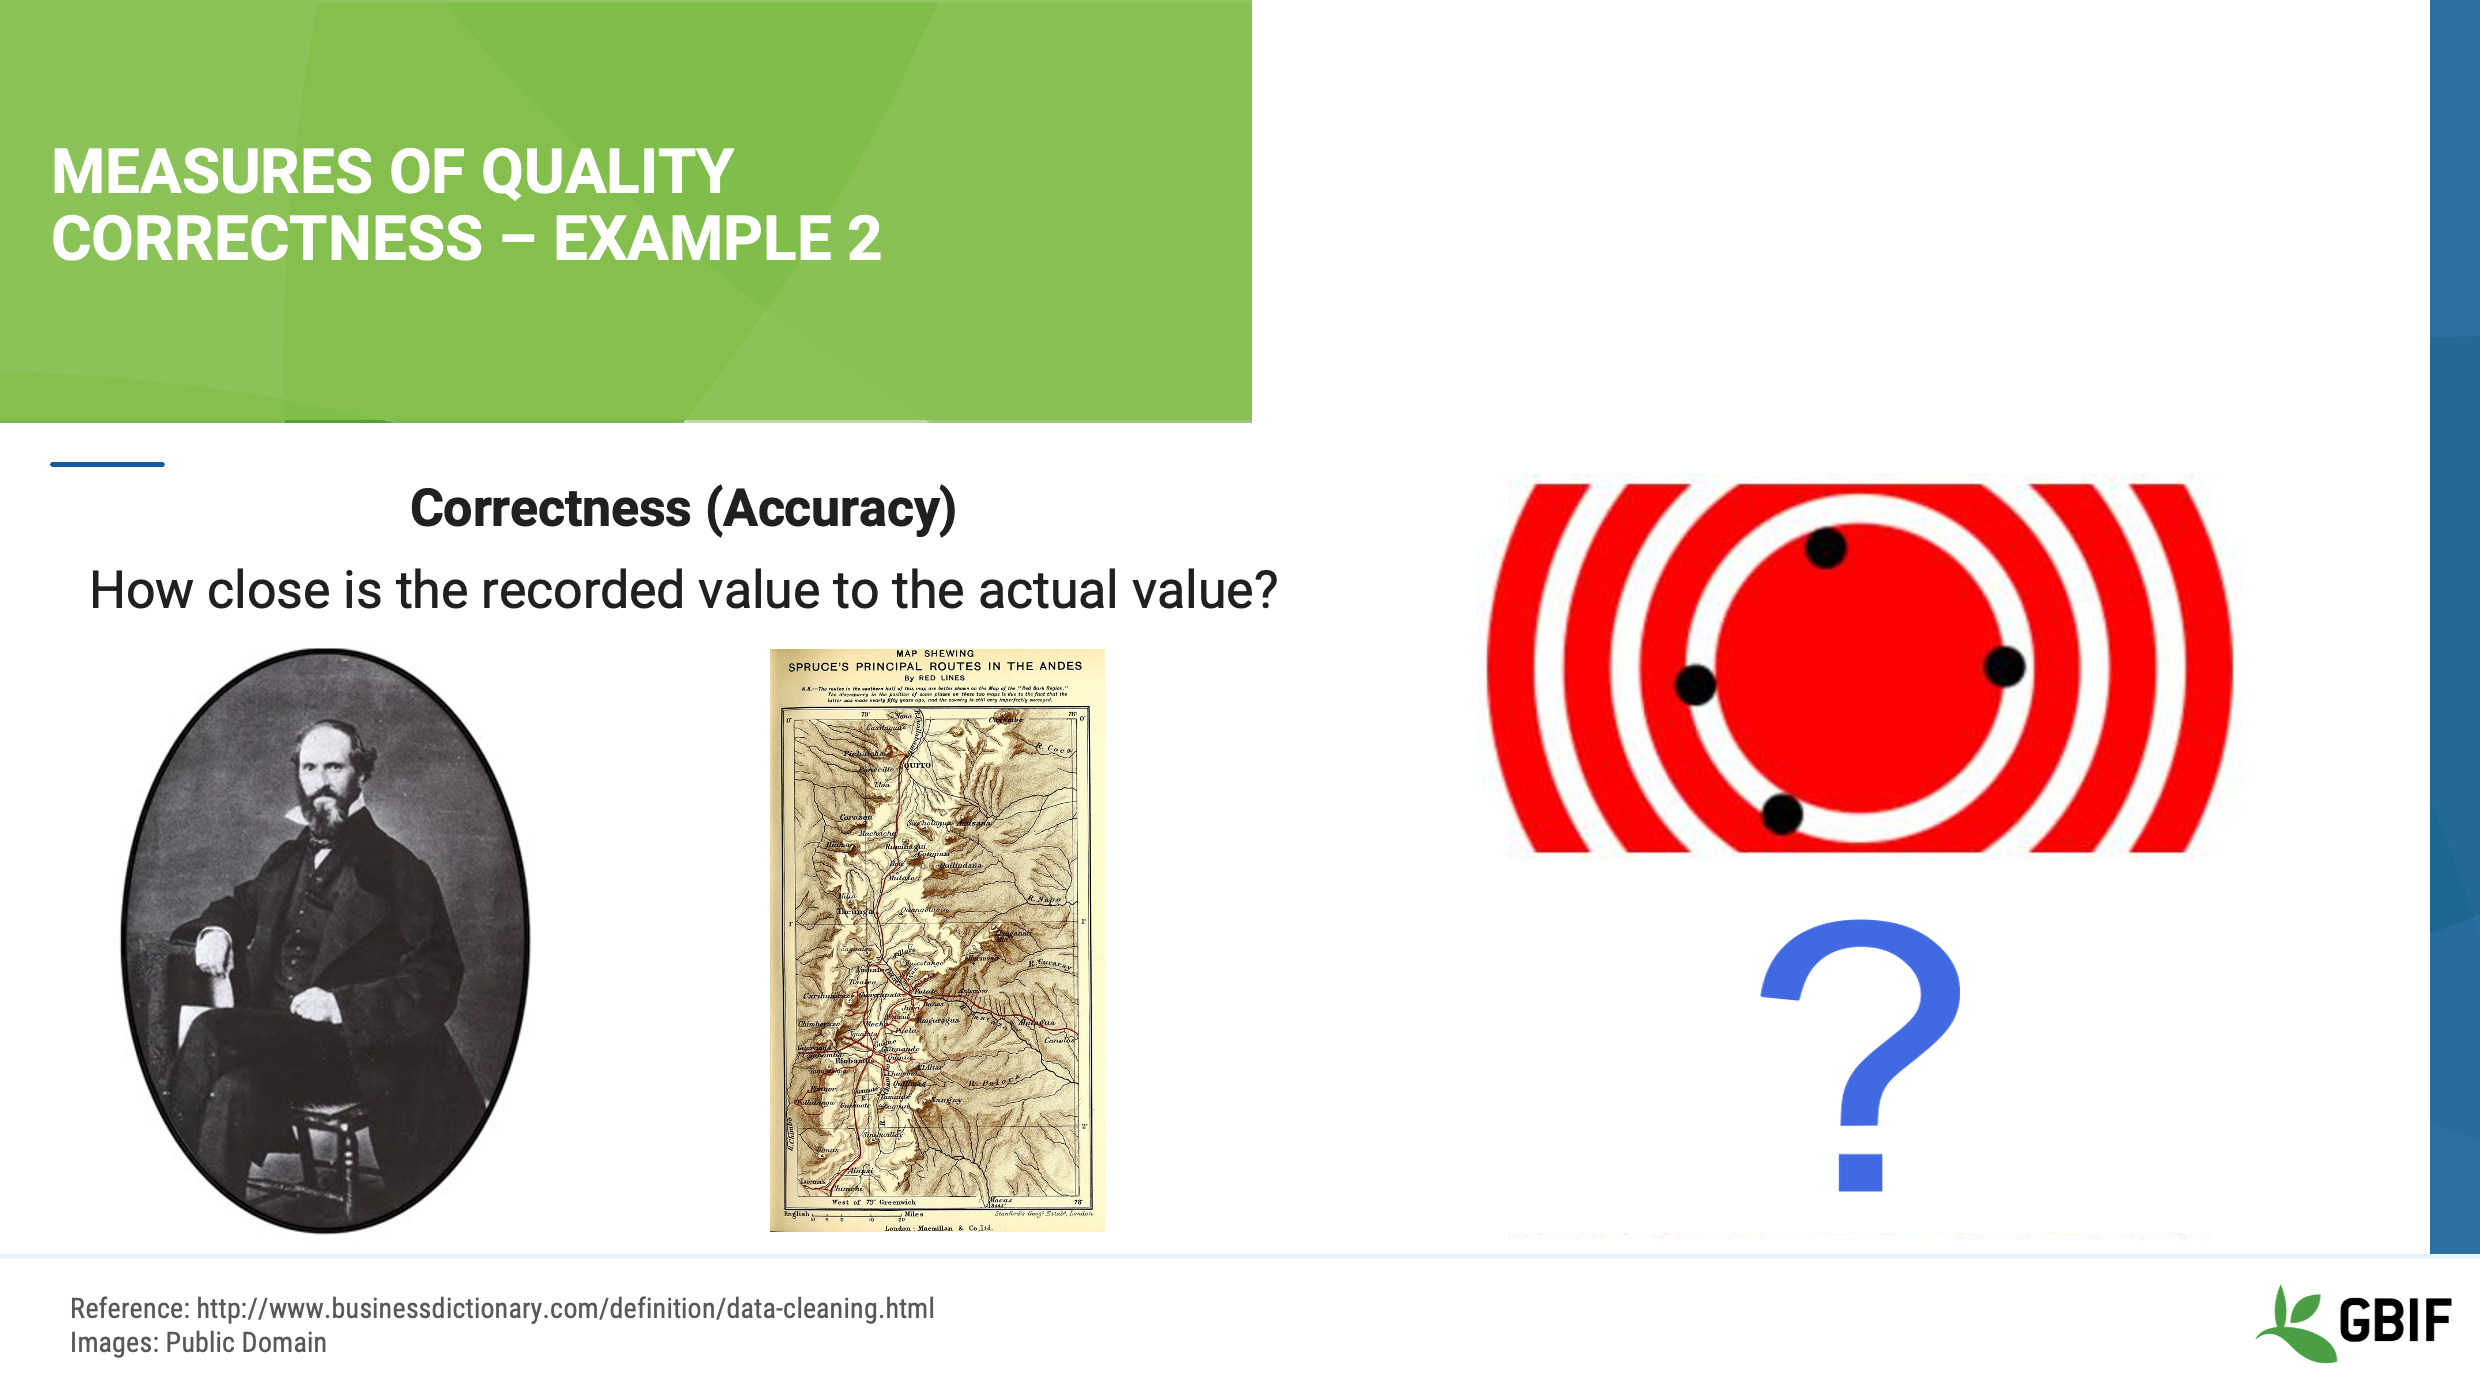
В данном случае ответ на первый вопрос — да: 49007 действительно является почтовым индексом Каламазу, поэтому информация о местонахождении достаточно точна. Но что можно сказать о коллекторе — Ричарде Спрусе (Richard Spruce)?
Источники изображений: https://en.wikipedia.org/wiki/Richard_Spruce#/media/File:Spruce_Richard.jpg https://archive.org/details/notesofbotanisto21908spru

Слайд 19 — Показатели качества — Корректность: пример 2
Действительно, существовал известный ботаник по имени Ричард Спрус. Он родился в 1817 году и умер в 1893 году, однако собирал материал в бассейне Амазонки и Андах в Южной Америке. Здесь явно есть несоответствие, поэтому нам необходимо выяснить больше информации о коллекторе, прежде чем мы сможем быть уверены в корректности этих данных. Источники изображений: https://en.wikipedia.org/wiki/Richard_Spruce#/media/File:Spruce_Richard.jpg https://archive.org/details/notesofbotanisto21908spru
Слайд 20 — Показатели качества — Согласованность
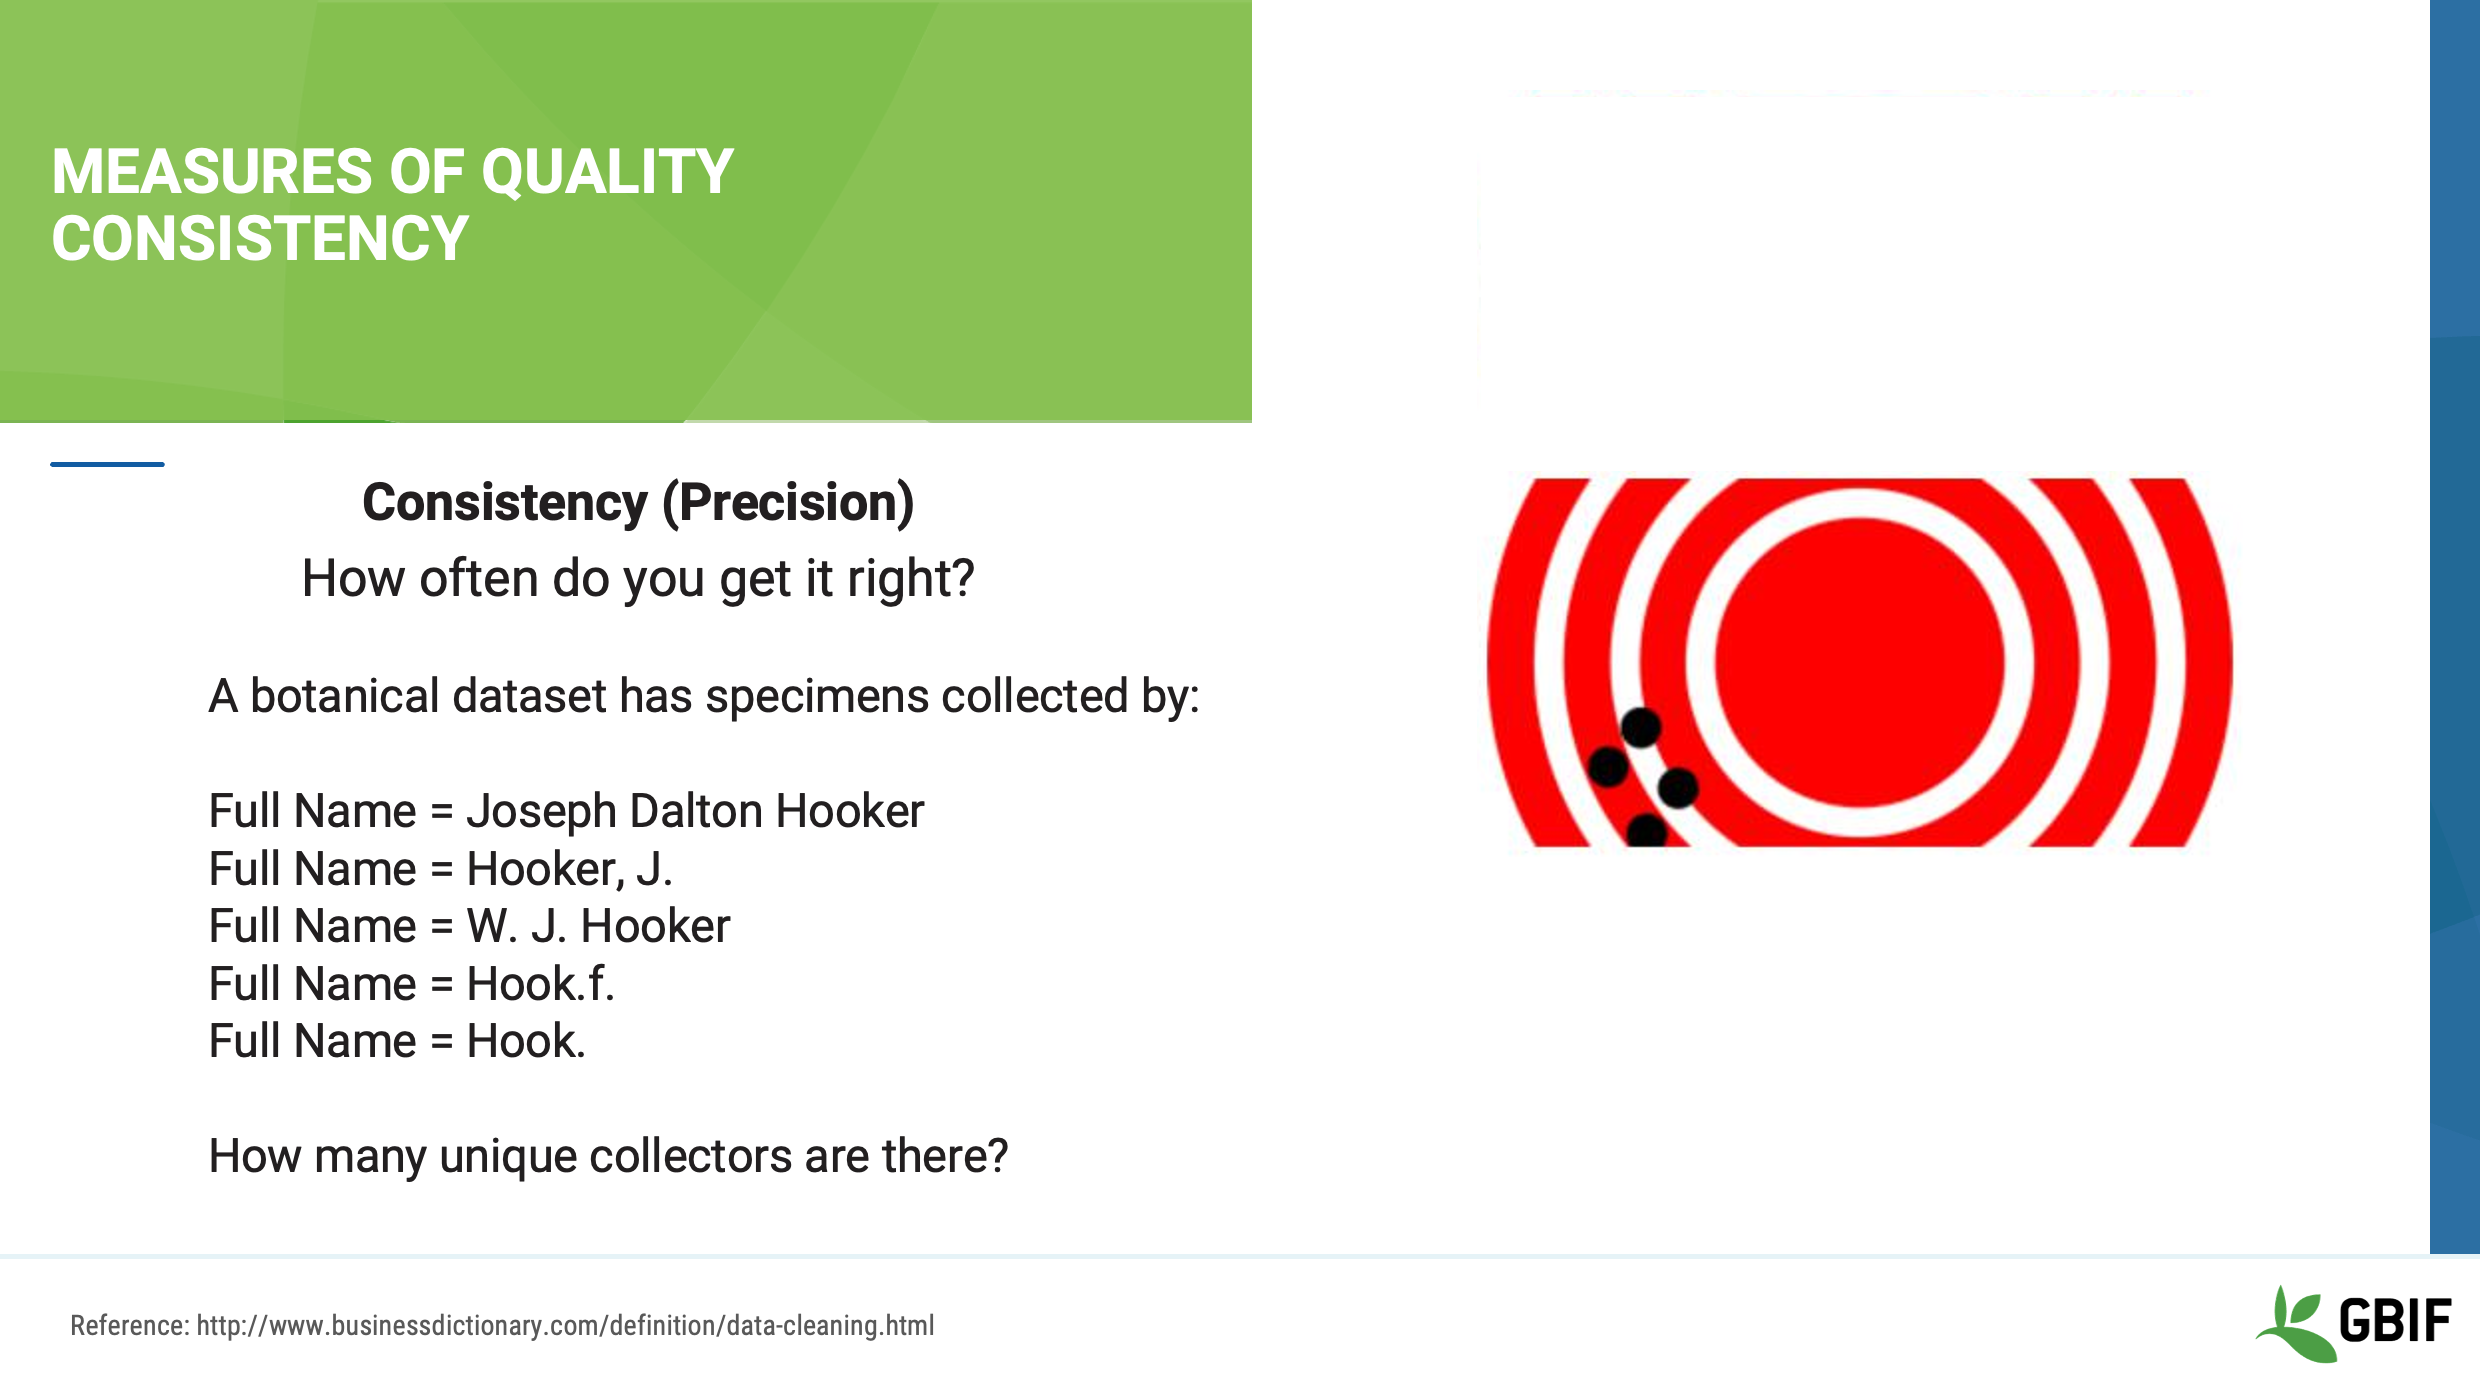
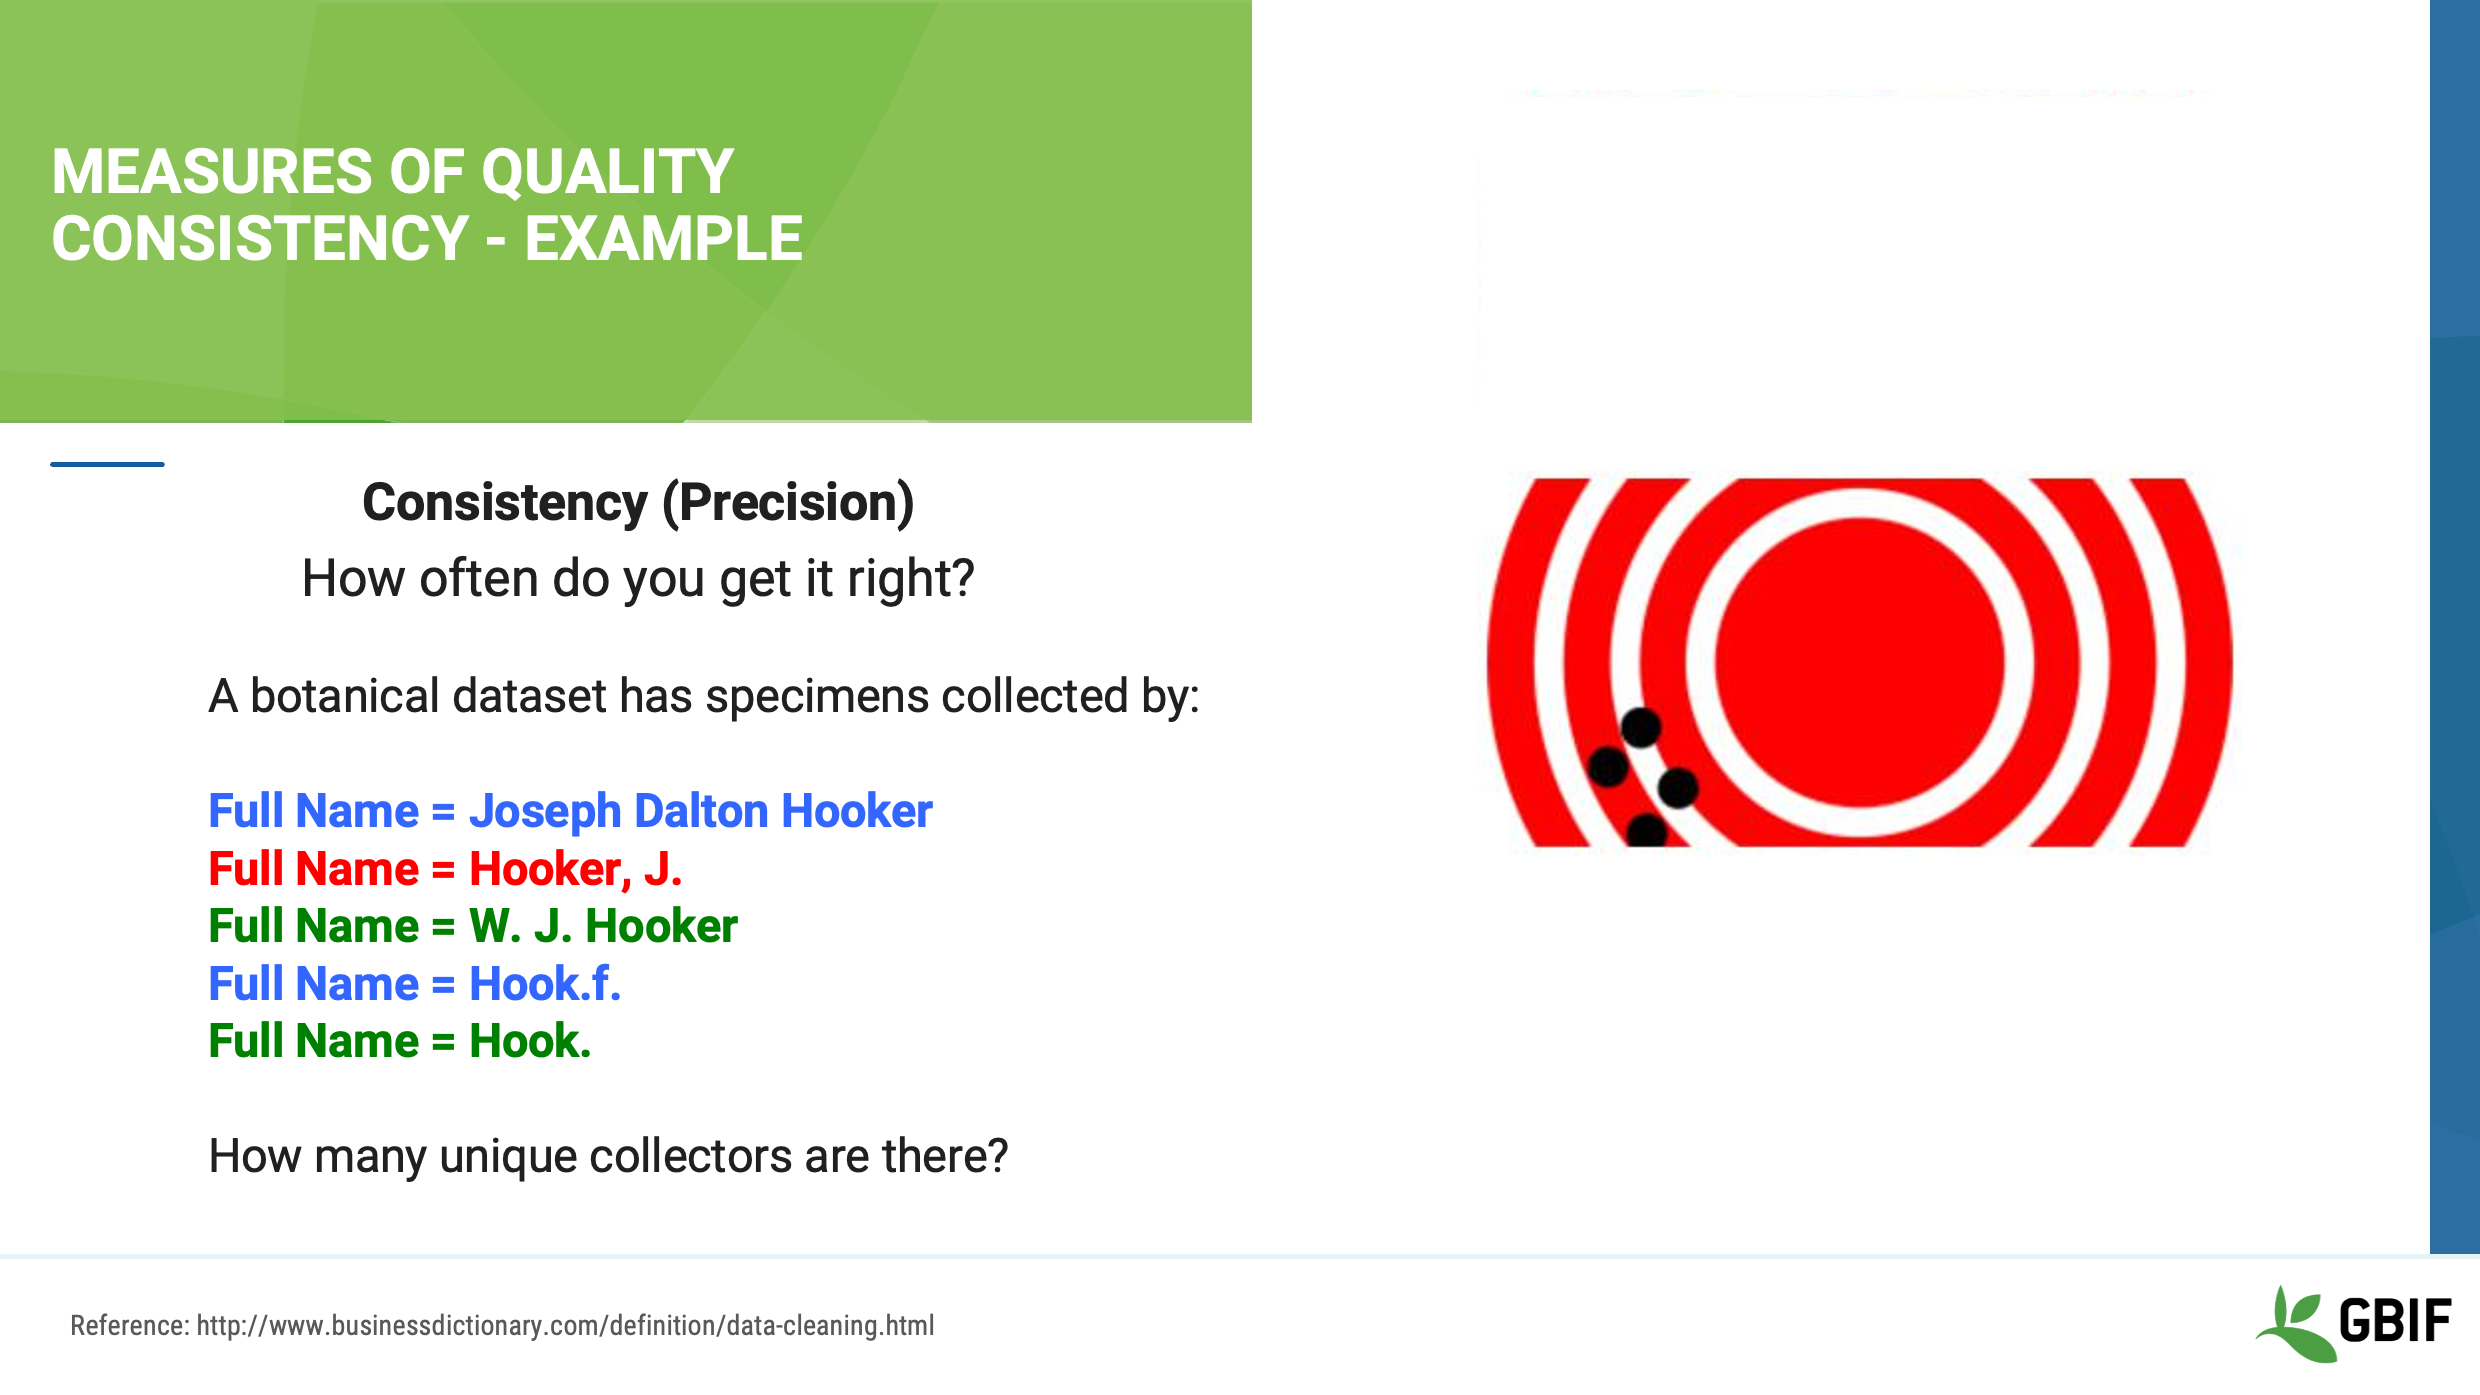
Теперь рассмотрим, что означает для данных согласованность (Consistency), или прецизионность (precision). Согласованность показывает, насколько часто вы получаете один и тот же результат, независимо от того, где находится центр мишени. Например, ваш набор данных содержит записи о находках растений и поле, или столбец, с названием «Full Name». В этом поле указано имя коллектора образца. Как вы видите, здесь приведены пять разных вариантов имени, но сколько на самом деле уникальных коллекторов? Можно ли определить это, просто взглянув на имена?
Слайд 21 — Показатели качества — Согласованность
Иногда, если вы хорошо знакомы с набором данных, то можете определить количество представленных в нём коллекторов, просто взглянув на данные. Однако, если данные вам недостаточно знакомы, может потребоваться дополнительное исследование, уточнение информации или обращение к исходным полевым записям. В данном примере, если вы предположили, что эти пять вариантов имени относятся к двум или трём уникальным коллекторам, вы правы: Синим цветом выделены Джозеф Далтон Хукер (Joseph Dalton Hooker) и Hook.f. — это один и тот же человек. Hook.f. — это аббревиатура, используемая для обозначения Джозефа Далтона Хукера (1817–1911). Зелёным цветом выделены W. J. Hooker и Hook., которые обозначают одного и того же человека. Hook. — это сокращение от Уильяма Джексона Хукера (1785–1865). Уильям, собственно, был отцом Джозефа. Наконец, красным цветом выделено имя «Hooker, J.». Эта запись может быть ошибочным или опечатанным вариантом имени Джозефа или Уильяма Гукера либо относиться к третьему человеку с похожим именем. Поэтому для уточнения этих данных потребуется дополнительное исследование. Источник: http://www.ipni.org/ipni/advAuthorSearch.do;jsessionid=087C235AF7757EF21CA33FF5325C94C7?find_forename=&find_surname=Hooker&find_abbreviation=&find_isoCountry=&output_format=normal&back_page=authorsearch&query_type=by_query
Слайд 22 — Очистка данных
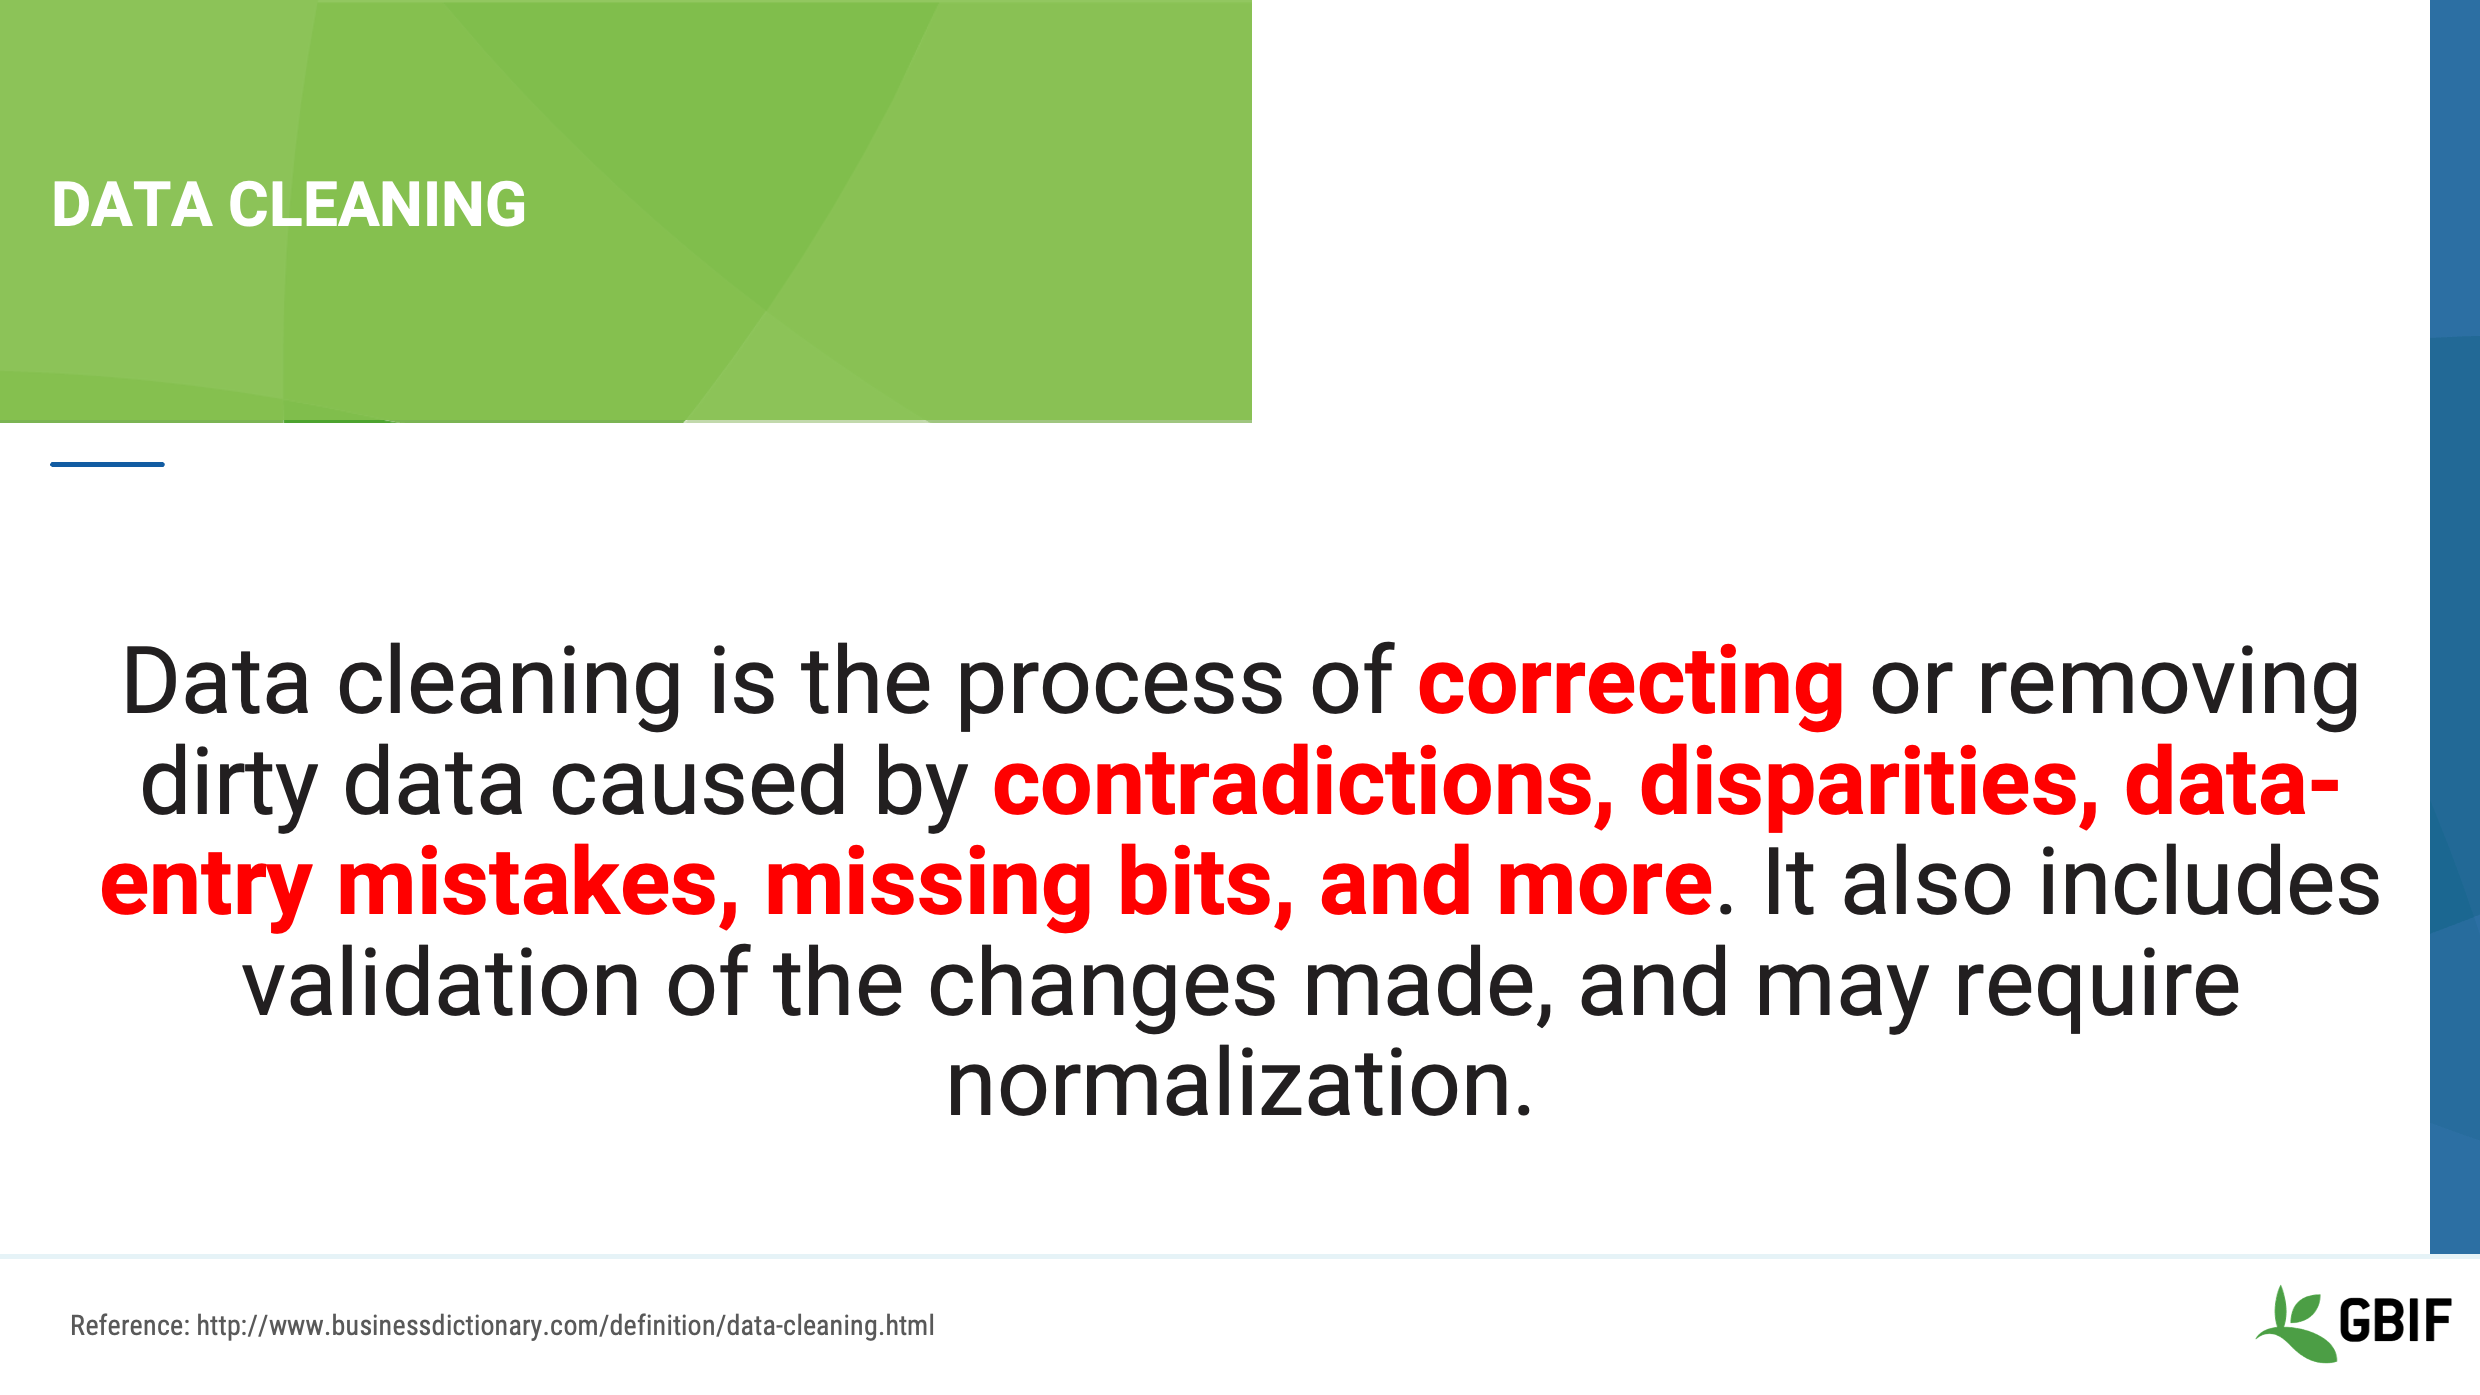
Мы только что рассмотрели несколько простых примеров, иллюстрирующих два показателя качества данных. Эти примеры должны дать вам базовое представление о том, как выявлять неточности и несогласованности в данных. Процесс документирования и исправления таких проблем или ошибок называется очисткой данных. Более конкретно: Очистка данных — это процесс исправления или удаления некорректных данных, появившихся в результате противоречий, несоответствий, ошибок ввода, отсутствующих значений и других проблем. Он также включает проверку внесённых изменений и при необходимости может требовать нормализации данных. То, насколько тщательно мы проводим очистку данных — или не проводим её вовсе, — влияет на то, как пользователи оценивают пригодность наших данных для использования. При этом вам не обязательно самостоятельно выполнять всю очистку данных. Более того, распространено ошибочное представление о том, что перед публикацией данных необходимо обязательно исправить все ошибки. На практике вы можете очистить данные лишь в той мере, в какой позволяют имеющиеся у вас время, знания и ресурсы. Поэтому крайне важно документировать, что вам известно и что неизвестно о ваших данных, чтобы после их публикации пользователи могли оценить уровень их качества.
Слайд 23 — Заключение
Это видео входит в серию презентаций, используемых в рамках курса GBIF «Мобилизация данных о биоразнообразии». Учебная программа по мобилизации данных о биоразнообразии была первоначально разработана в рамках Программы развития информации о биоразнообразии, финансируемой Европейским союзом.
Эта презентация была первоначально подготовлена Шэрон Грант (Sharon Grant) при дополнительном участии Дага Эндресена (Dag Endresen) и Дэвида Блума (David Bloom). Текст презентации озвучил Дэвид Блум (David Bloom).
Принципы обеспечения качества данных
| Ниже приведен отрывок из руководства Артура Чепмена «Принципы качества данных». Полный текст, ссылки и переводы можно найти на сайте GBIF.org. |
Прежде чем перейти к подробному рассмотрению качества данных и его оценки применительно к данным о находках видов, необходимо определить и объяснить ряд понятий. К ним относятся само понятие качества данных, термины «точность» (accuracy) и «прецизионность» (precision), которые часто используются некорректно, а также понятия первичных данных о видах и данных о находках видов.
Данные о находках видов
В данном контексте данные о находках видов (Species-occurrence data) включают информацию с этикеток отдельных экземпляров или серий образцов, хранящихся в музеях и гербариях, данные наблюдений, а также данные экологических обследований. Как правило, такие данные имеют точечную пространственную привязку, однако они могут быть представлены и в виде линий (например, данные учётов вдоль трансект или сборов вдоль реки), полигонов (наблюдения в пределах определённой территории, например национального парка) или регулярной сетки (наблюдения или результаты учётов, привязанные к ячейкам сетки). В целом речь идёт о данных с географической привязкой, то есть о записях, содержащих информацию, позволяющую связать их с определённым местоположением — как с помощью географических координат (например, широты и долготы или координат UTM), так и без них (текстовое описание местонахождения, высота над уровнем моря, глубина), а также с определённым временем (дата, время суток).
Как правило, данные также связаны с определённым таксономическим названием, однако могут включать и сборы, таксономическая принадлежность которых ещё не установлена. Иногда этот термин используется как синоним понятия «первичные данные о видах» (primary species data)..
Первичные данные о видах
Термин «первичные данные о видах» используется для обозначения необработанных данных о сборах, а также данных, не содержащих пространственных характеристик. Он включает таксономические и номенклатурные данные без пространственной привязки, например научные названия, таксоны и таксономические концепции, не связанные с конкретными географическими местоположениями.
Точность и прецизионность
Понятия точности и прецизионности часто путают, а различия между ними, как правило, недостаточно хорошо понимают.
Точность (Accuracy) характеризует степень близости измеренных значений, наблюдений или оценок к реальному или истинному значению (либо к значению, принятому за истинное, например к координатам опорного геодезического пункта).
Точность (Precision, или Resolution) можно разделить на два основных типа. Статистическая точность (Statistical precision) характеризует степень согласованности результатов повторных наблюдений между собой. Она не связана с их близостью к истинному значению, поэтому результаты могут обладать высокой статистической точностью, но при этом иметь низкую точность (Accuracy). Числовая точность (Numerical precision) определяется количеством значащих цифр, с которыми записано значение наблюдения. Эта проблема стала особенно заметной с распространением компьютеров. Например, база данных может выдавать значения широты и долготы в десятичных градусах с 10 знаками после запятой, что соответствует примерно 0,01 мм, хотя в действительности пространственное разрешение исходной записи может составлять лишь 10–100 м (3–4 знака после запятой). Это часто создаёт ложное представление как о пространственном разрешении данных, так и об их фактической точности.
Эти понятия — точность и прецизионность — применимы не только к пространственным, но и к другим типам данных. Например, собранный экземпляр может быть определён до уровня подвида (то есть с высокой прецизионностью), но при этом отнесён к неправильному таксону (низкая точность). И наоборот, экземпляр может быть определён только до уровня семейства (высокая точность, но низкая прецизионность).
Качество данных
Качество данных — многомерное понятие, охватывающее управление данными, моделирование и анализ, контроль и обеспечение качества, хранение и представление данных. Как независимо друг от друга отмечали Chrisman (1991) и Strong et al. (1997), качество данных зависит от целей их использования и не может оцениваться в отрыве от пользователя. Сами по себе данные, хранящиеся в базе данных, не обладают реальным качеством или ценностью (Dalcin 2004). Они имеют лишь потенциальную ценность, которая реализуется только тогда, когда кто-либо использует эти данные для решения практических задач. Качество информации определяется её способностью удовлетворять потребности пользователей и соответствовать их требованиям (English 1999).
Redman (2001) предположил, что для того, чтобы данные были пригодны для использования, они должны быть доступными, точными, актуальными, полными, согласованными с другими источниками, релевантными и всесторонними, иметь необходимый уровень детализации, а также быть удобными для чтения и интерпретации.
Один из вопросов, который необходимо учитывать специалисту, ответственному за управление данными, заключается в том, какие изменения следует внести в базу данных, чтобы сделать её более удобной для широкого круга пользователей (то есть расширить возможности её использования и повысить её востребованность) и тем самым обеспечить пригодность данных для решения более широкого спектра задач. При этом необходимо найти баланс между повышением удобства использования данных и объёмом усилий, необходимых для расширения функциональных возможностей базы данных. Для этого могут потребоваться, например, разделение содержимого полей на отдельные элементы, добавление информации о географической привязке и другие меры.
Обеспечение и контроль качества
Различие между контролем качества (Quality Control) и обеспечением качества (Quality Assurance) не всегда очевидно. Taulbee (1996) разграничивает эти понятия и подчёркивает, что для достижения установленных целей в области качества они не могут существовать друг без друга. Она определяет контроль качества как оценку качества на основе внутренних стандартов, процессов и процедур, разработанных для контроля и мониторинга качества. Обеспечение качества, в свою очередь, определяется как оценка качества на основе стандартов, внешних по отношению к рассматриваемому процессу. Оно предполагает проверку выполняемых действий и процедур контроля качества с целью убедиться, что конечные результаты соответствуют заранее установленным стандартам качества.
В рамках подхода, более ориентированного на бизнес-процессы, Redman (2001) определяет обеспечение качества как «деятельность, направленную на создание информационных продуктов, не содержащих ошибок, которые удовлетворяют наиболее важные потребности наиболее значимых пользователей при минимально возможных затратах».
Как именно следует применять эти понятия на практике, остаётся не вполне ясным. В большинстве случаев они, по-видимому, используются практически как синонимы для обозначения совокупности процессов управления качеством данных.
Неопределенность
Неопределённость (Uncertainty) можно рассматривать как «меру неполноты наших знаний или информации о неизвестной величине, истинное значение которой можно было бы установить при наличии идеального измерительного прибора» (Cullen and Frey 1999). Неопределённость отражает степень понимания данных наблюдателем и, таким образом, характеризует скорее знания наблюдателя, чем сами данные. Неопределённость присутствует в любых данных. Основная сложность заключается в том, чтобы правильно зафиксировать, понять и наглядно представить её таким образом, чтобы другие пользователи также могли её оценить. Неопределённость является ключевым понятием для понимания рисков и их оценки.
Ошибка
Ошибка (Error) охватывает как недостаточную прецизионность данных, так и их отклонения от истинных значений. Существует множество факторов, способствующих возникновению ошибок. Обычно ошибки подразделяют на случайные и систематические. Случайная ошибка (Random error) представляет собой отклонение от истинного значения, возникающее случайным образом. Систематическая ошибка, или смещение (Systematic error или Bias), возникает вследствие однонаправленного смещения значений и в картографии иногда описывается с использованием понятия «относительная точность» (Relative accuracy) (Chrisman 1991). При оценке пригодности данных для использования (Fitness for use) систематические ошибки могут быть допустимыми для одних задач и делать данные непригодными для других.
Примером может служить использование другой геодезической системы отсчёта¹, которое, если она последовательно применяется на протяжении всего анализа, может не вызывать существенных проблем. Однако проблемы возникают, когда в анализе объединяются данные из разных источников, содержащие различные систематические смещения. Например, это могут быть источники данных, использующие разные геодезические системы отсчёта, или данные, в которых определение таксонов проводилось с использованием более ранней версии номенклатурного кодекса.
«Поскольку ошибки неизбежны, их следует рассматривать как одну из фундаментальных характеристик данных» (Chrisman 1991). Только при условии, что информация об ошибках включена в описание данных, становится возможным оценить ограничения, связанные с самими данными, и даже ограничения существующих знаний. Известные ошибки, относящиеся к трём измерениям данных — пространственному, атрибутивному и временному, — необходимо измерять, оценивать количественно, регистрировать и документировать.
Проверка и очистка
Валидация данных — это процесс, направленный на выявление неточных, неполных или неправдоподобных данных. Он может включать проверку формата, полноты и правдоподобности данных, проверку соответствия допустимым диапазонам значений, анализ данных для выявления выбросов (географических, статистических, временных или экологических) и других ошибок, а также экспертную оценку данных специалистами в соответствующих предметных областях (например, систематиками). Как правило, в результате таких проверок подозрительные записи помечаются, информация о выявленных проблемах документируется, а сами записи подвергаются последующей проверке. Валидация также может включать проверку соответствия данных применимым стандартам, правилам и соглашениям. Важным этапом валидации и очистки данных является выявление первопричин обнаруженных ошибок и принятие мер, направленных на предотвращение их повторного возникновения (Redman 2001).
Очистка данных (Data cleaning) — это процесс исправления ошибок, выявленных в ходе валидации данных. Термин data cleaning является синонимом data cleansing, хотя иногда под data cleansing понимают более широкий процесс, включающий как валидацию, так и очистку данных. При очистке данных важно не допустить случайной потери информации, а любые изменения существующих данных необходимо вносить с особой осторожностью. Зачастую предпочтительнее сохранять в базе данных как исходные (оригинальные), так и исправленные данные, чтобы в случае ошибок, допущенных в процессе очистки, можно было восстановить первоначальную информацию.